Matemática 05 2
Distribuciones Continuas
Al igual que había Función de Distribución Discreta, ahora vamos a ver varias continuas.
A pesar que se les llamas Distribución lo más importante son sus Función de Densidad.
Distribución Normal
Empezamos con la Distribución Normal porque tiene un rol central en la Estadística, su recorrido son los reales.
Tiene dos Parámetros, u que le da su centro, y sigma cuadrado que le da el ancho:
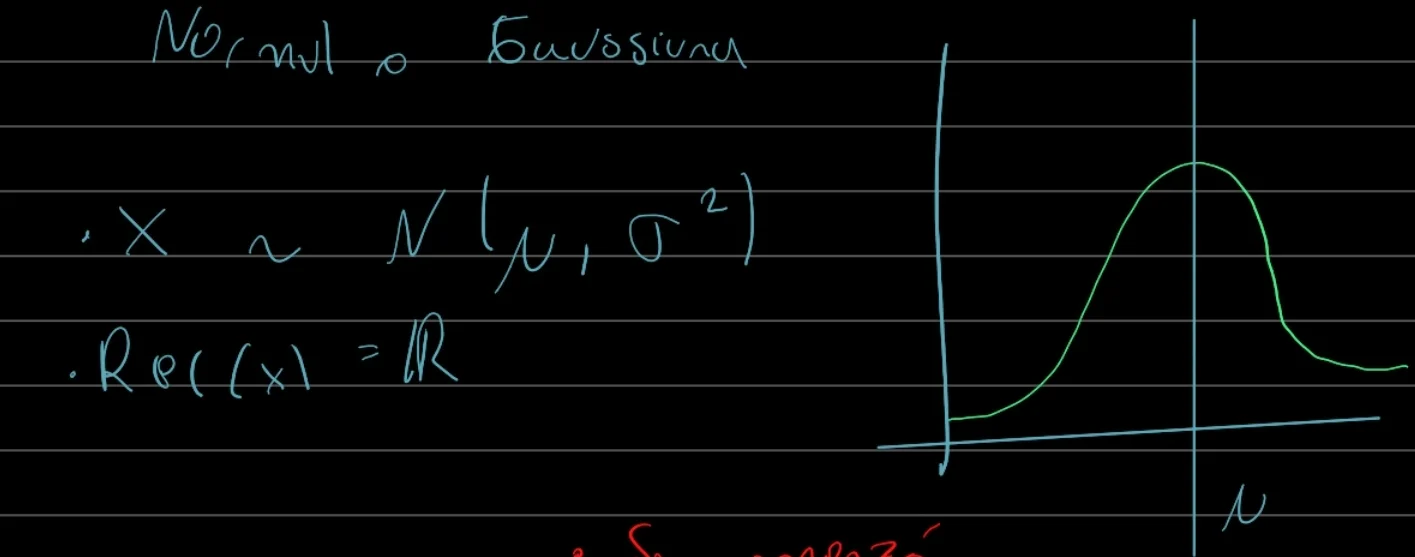
Es siempre simétrica respecto a mu.
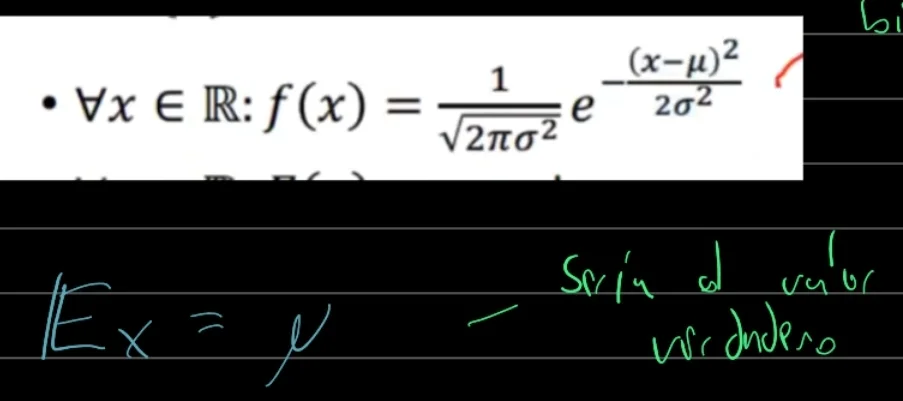
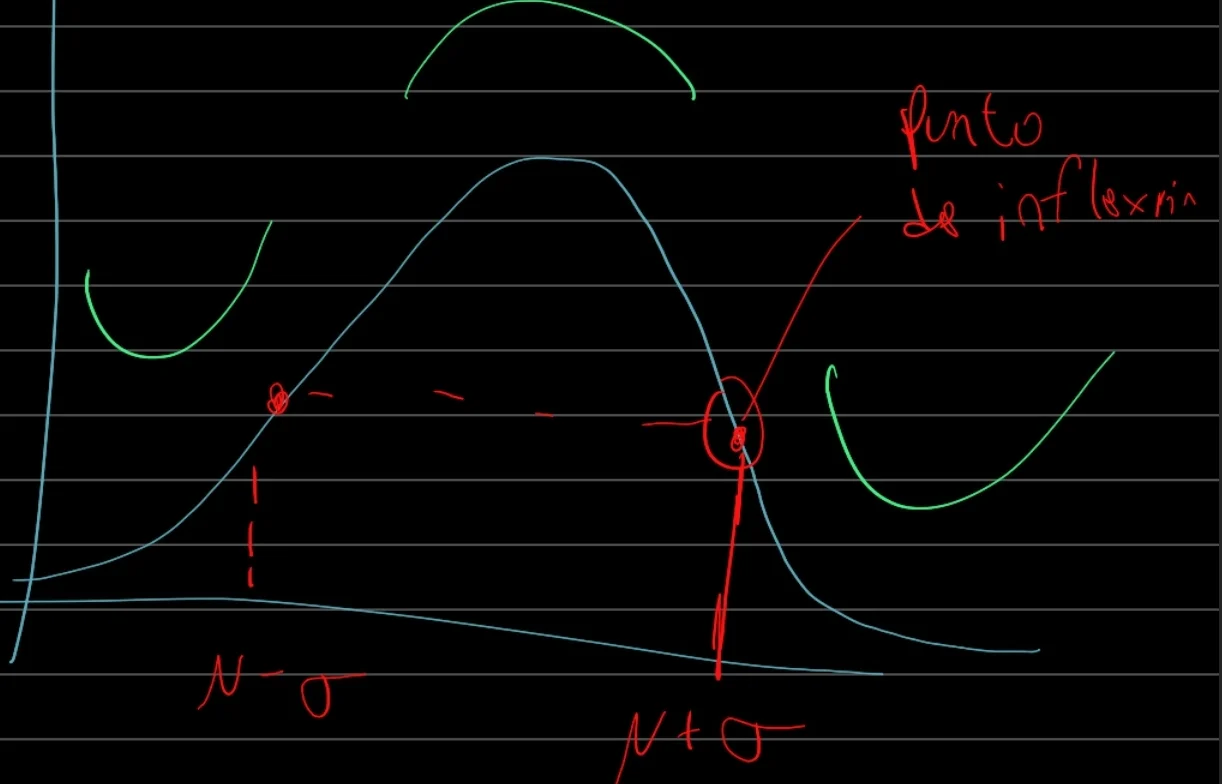
Sus Punto de Inflexión son en u+-sigma:
Al no haber primitivas, y para facilitar el calculo, se utiliza una Transformación Lineal que estandariza a x, a la Normal (0,1), que llamamos z:
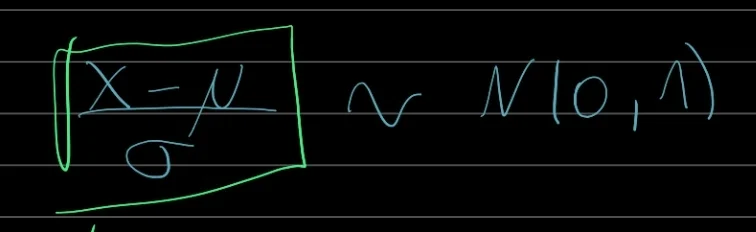
Y teniendo z, podemos buscar los valores de la integral en tablas.
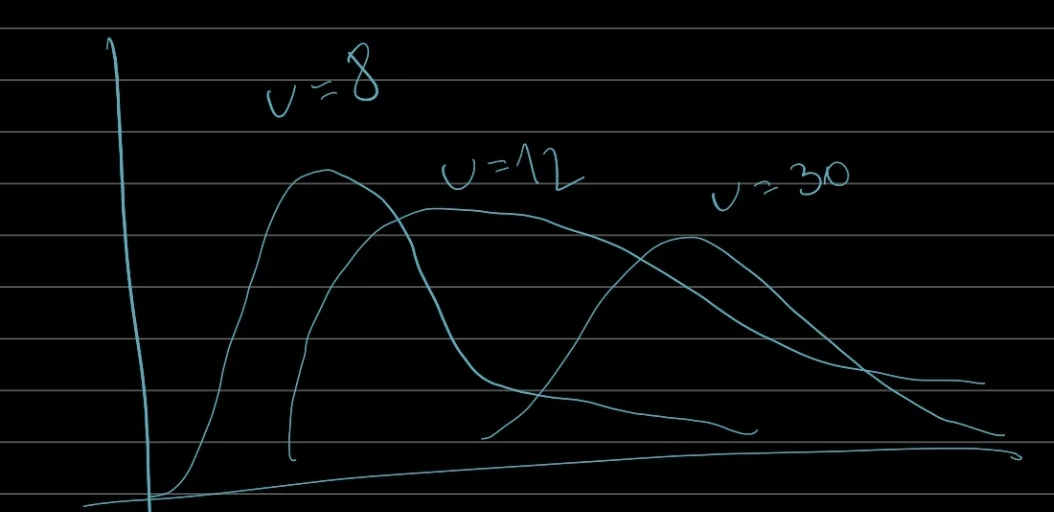
Chi cuadrado
La Chi Cuadrado es la que se da de la suma de Normales (0,1) Independientes, al cuadrado
Su Parámetros (n)son la cantidad de normales que habría sumadas
Su Esperanza es n
y su Varianza es 2n
T de Student
La distribución t de Student es como una Normal, pero con la cola más pesada, por lo que estima mejor con muestras pequeñas que la normal.
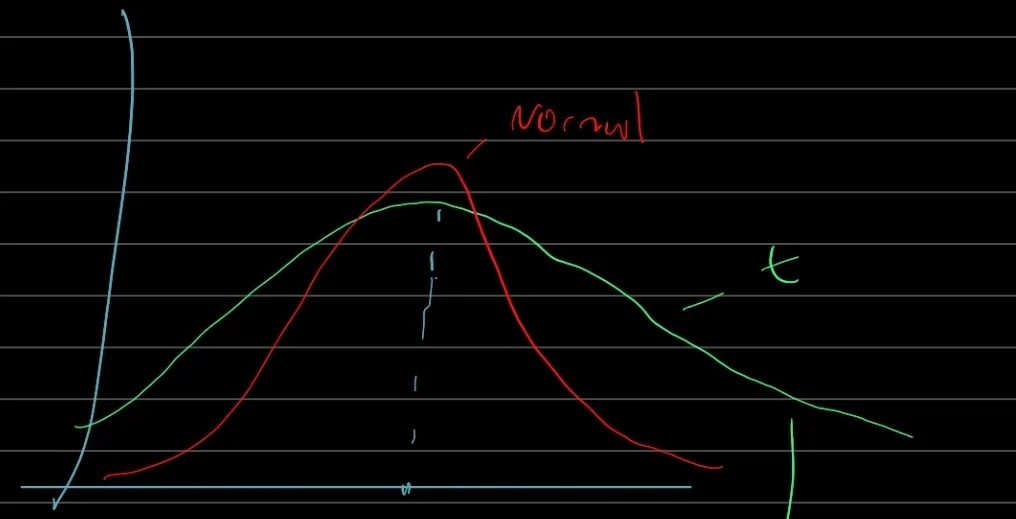
Y cuanto más grande la muestra, más se parece a la Normal.
Además la t surge de dividir una normal con una chi cuadrado, y hereda el parametro de la chi.
F de Fisher
La F de Fisher tiene n y m grados de libertad y surge del cociente de dos Chi Cuadrado.
Promedio
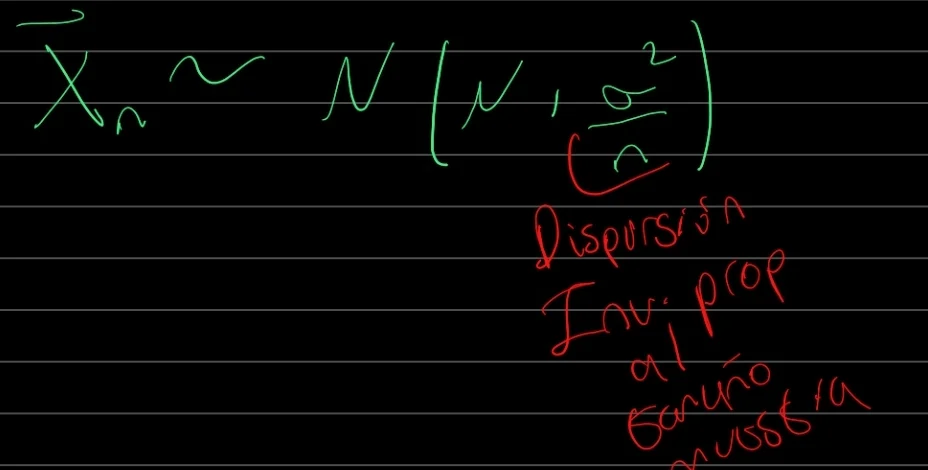
El Promedio de una Muestra Aleatoria tiene como Distribución a una Normal:
Varianza
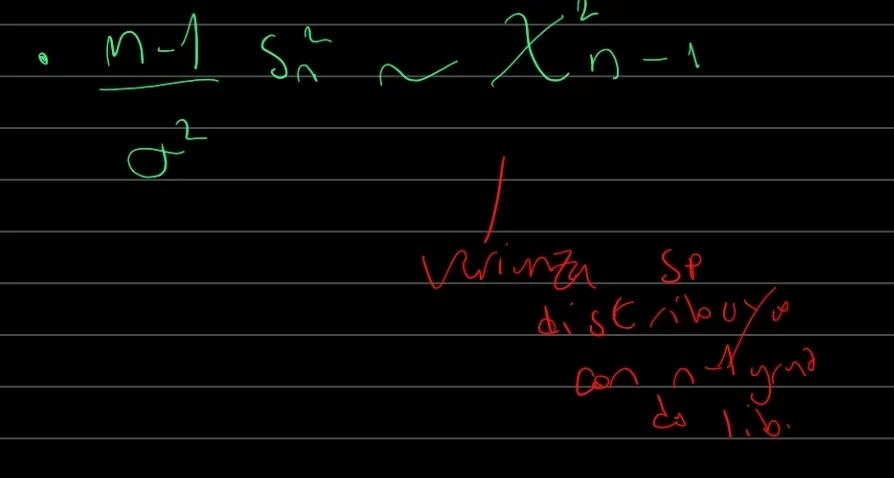
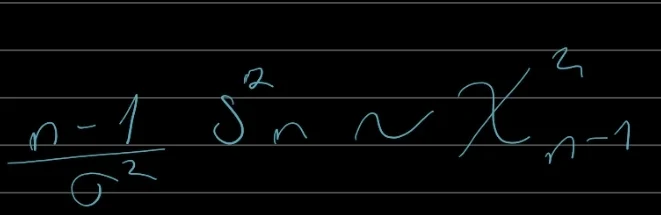
La Varianza Muestral también tiene una Distribución, pero en este caso es una Chi Cuadrado:
Teorema del límite central
El Teorema del Límite Central nos da una herramienta importante, ya que dice que con un n suficientemente grande, podemos aproximar la Distribución del Promedio a laNormal, aunque la distribución a la que le estemos calculando el Promedio no sea Normal.
Estimación Puntual
La gran mayoría de las veces, no vamos a conocer el verdadero valor de los Parámetros de las distribuciones, por lo que necesitaremos estimarlos.
Para ello vamos a hacer Muestra Aleatoria, y calcular diferentes Estimadores.
Por ejemplo el Promedio que es el mejor estimador de u.
O la Varianza Muestral , que es el mejor estimador de sigma cuadrado.
Los Estimadores pueden depender de n y otras cosas provenientes de la muestra, pero no de Parámetros.
Si nos quedara dependiente de otro parámetro también habría que estimarlo a el.
Vamos a ver dos métodos para hallar los Estimadores.
Método de Momentos
El Método de Momentos se basa en usar los Momentos de orden k, y asociarlos a los Parámetros a estimar.
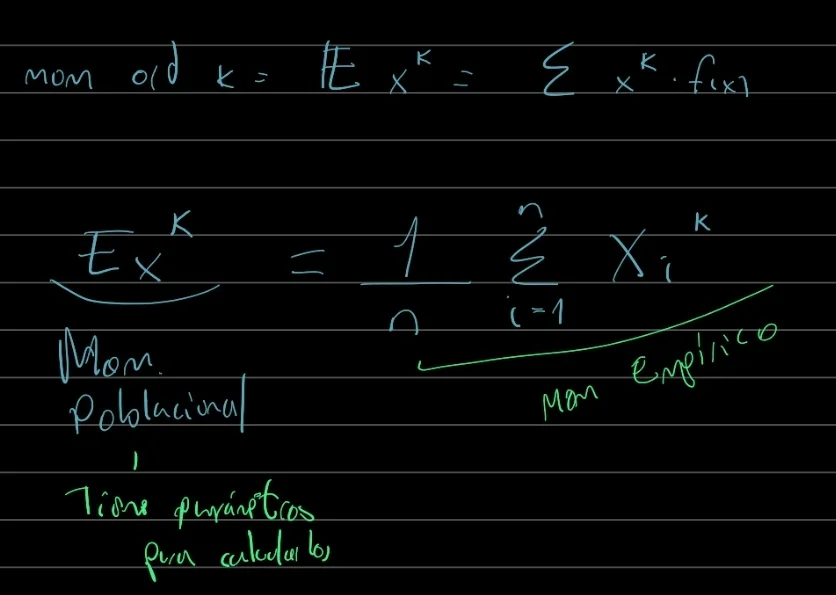
Y hacer Sistemas de Ecuaciones Lineales hasta tener Estimador para todos los Parámetros.
Para algunos este método da buenos resultados muy rápido, pero puede no ser el mejor en muchos casos.
Método de Máxima Verosimilitud
El Método de Máxima Verosimilitud se basa en hacer la Productoria de las Función de Densidad y buscar maximizarla.
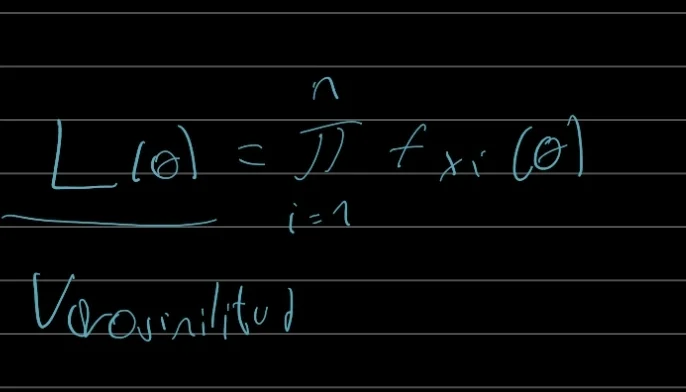
Al ser todo con productos, suele ser útil aprovecharnos de las propiedades del logaritmo, para facilitar el cálculo.
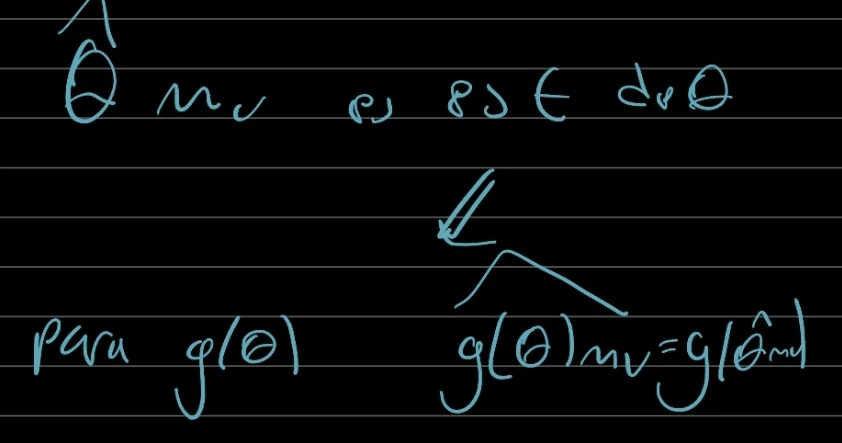
Luego, debemos derivar la función e igualarla a 0, y con despejando, podremos obtener el Estimador con el Método de Máxima Verosimilitud.
Si fuera de varias variables, habría que clasificarlo con la Hessiana y los Valor Propio.
Lo malo es que puede que no sea único.
Elegir Estimador
Cada estimador va a tener un Sesgo, y una Varianza.
El Sesgo es la diferencia entre la Esperanza del Estimador y el valor verdadero. Por lo que buscamos para que sea insesgado, que la Esperanza sea igual al Parámetros.
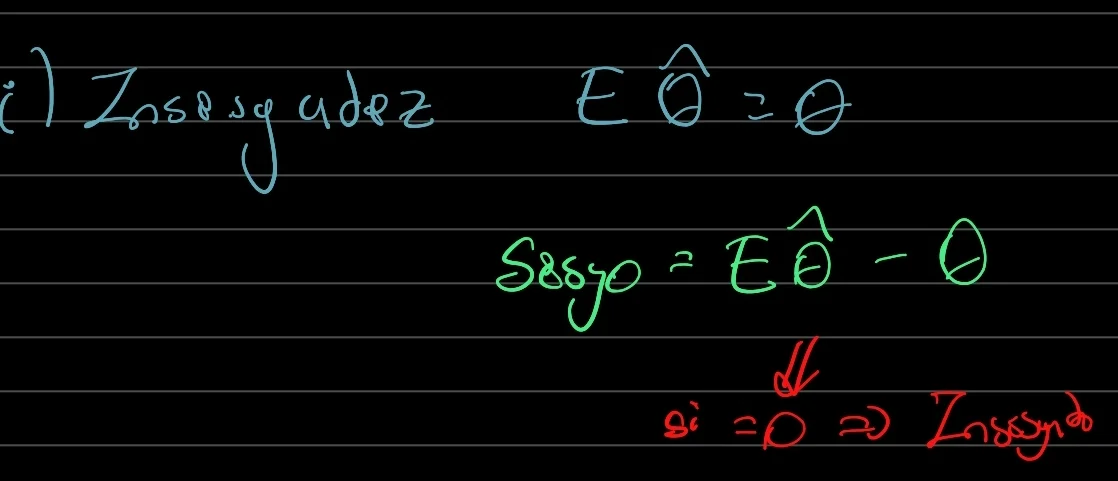
Además nos interesa tener en cuenta la Varianza, por lo que vamos a usar como criterio el Error Cuadrático Medio.
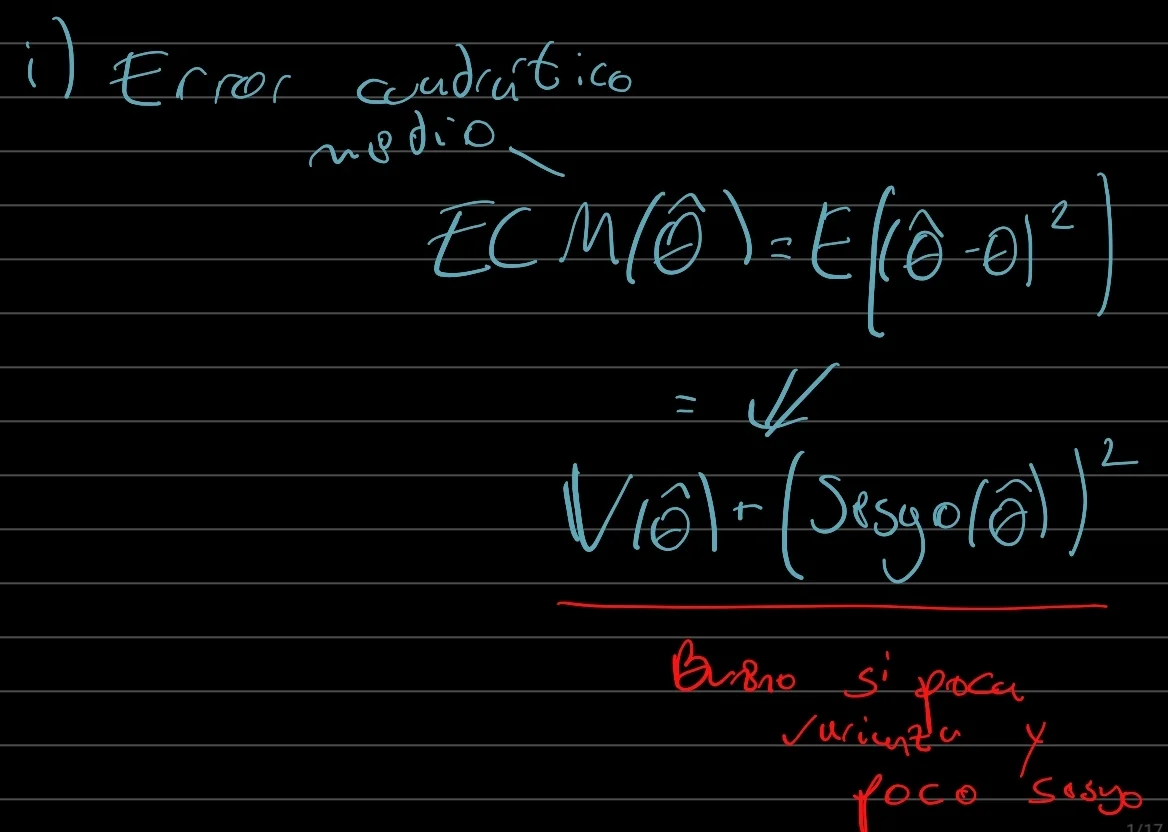
También hay una forma de calcular una Cota Inferior para la Varianza de los Estimadores de un Parámetros , lo que es útil porque nos dice si nuestro estimador tiene la mínima varianza o no.
Aunque si no lo es, no se sabe si habrá uno que la tenga.
Esta Cota es la Cota de Cramer-Rao, 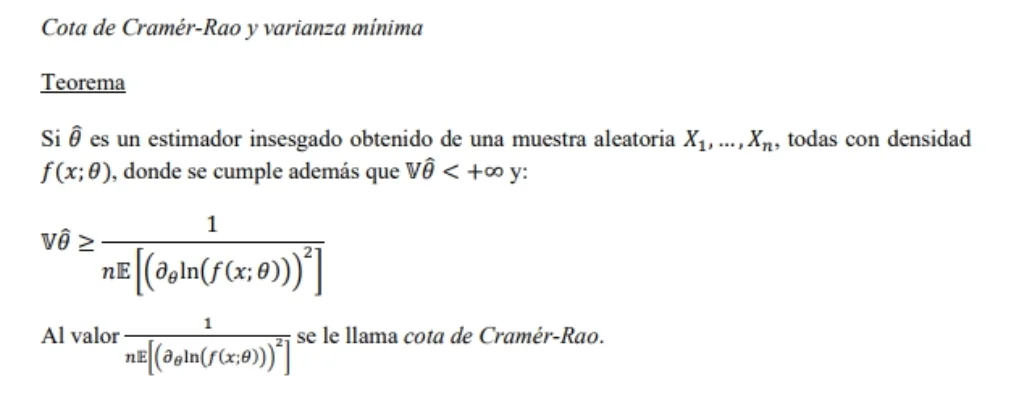
Estimación con Intervalos
Como dijimos, todos los Estimadores tienen su Varianza, por lo que vamos a definir Intervalo de Confianza, que con un Nivel de Confianza nos digan que el valor verdadero está en el.
Hacen más explícitos el posible error que solo decir la Varianza.
A mayor Nivel de Confianza, hay menor chance de que el valor verdadero no esté, pero se hace más grande el Intervalo.
Lo malo de los Intervalo de Confianza es que se van a construir de forma específica para cada caso, lo bueno es que conceptualmente son todos iguales.
Para mu de Normal varianza conocida
Si conozco la Varianza de una Normal, el intervalo es como hicimos en Analítica 1 1, con el Sigma de Repetibilidad:
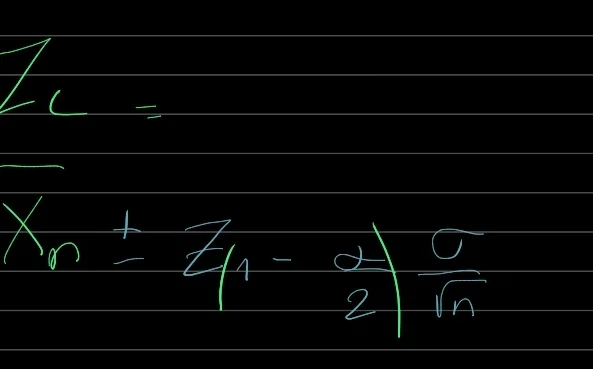
Esto puede ser usado también con una Distribución Binomial, ya que el Estimador de p es el Promedio:
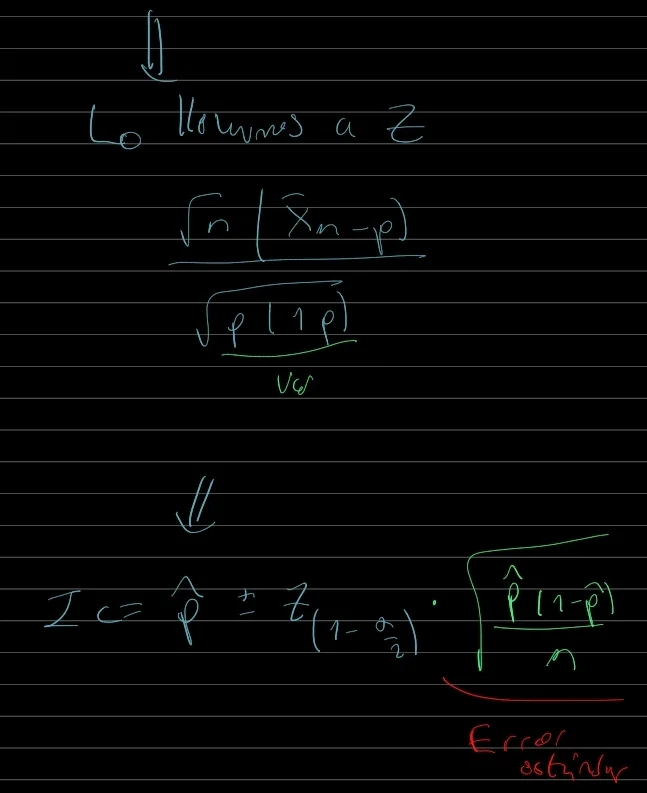
Para mu de Normal varianza DESconocida
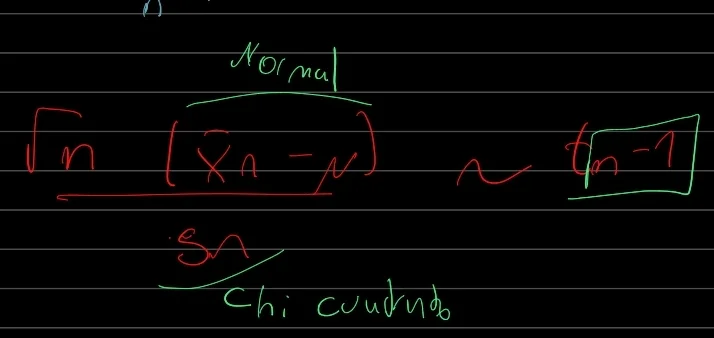
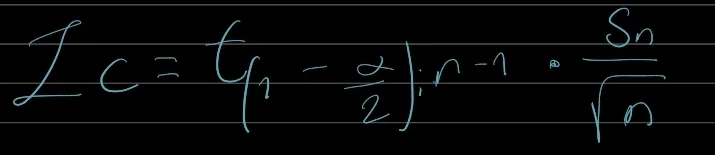
Al no conocer la Varianza, la debo estimar por lo que al estandarizar me va a quedar la t de Student en lugar de la Normal Z :
Para la Varianza de una normal
Para la Varianza de una Normal se usa que:
Y queda:
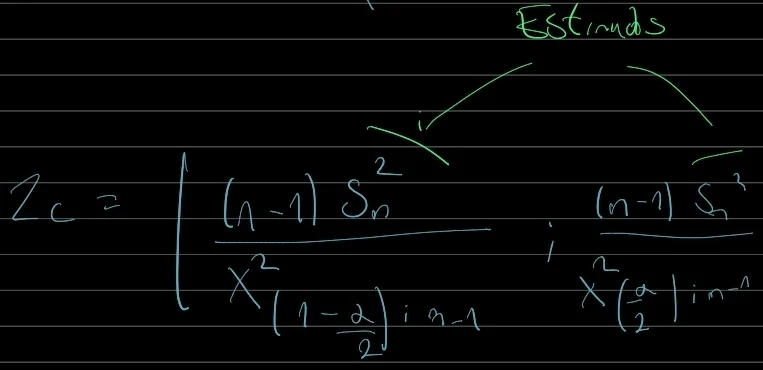
Test de Hipótesis
Los Test de Hipótesis van a ser la forma de tomar decisiones en base a datos y teoría Estadística.
Al ser basado en datos experimentales, nunca dan certezas.
Una Hipótesis en Estadística es una afirmación sobre una característica desconocida de la Población.
Puede ser simple (=) o compuesta (> x ej).
Siempre en los Test de Hipótesis se hacen 2 Hipótesis, la Hipótesis Nula, y la Hipótesis Alternativa.
Generalmente la Hipótesis Nula es simple y la alternativa compuesta.
Además siempre que hagamos un Test de Hipótesis vamos a tener que definir un Nivel de Significación, que es como el margen de error.
Aunque hay dos tipos de errores, y están ligados: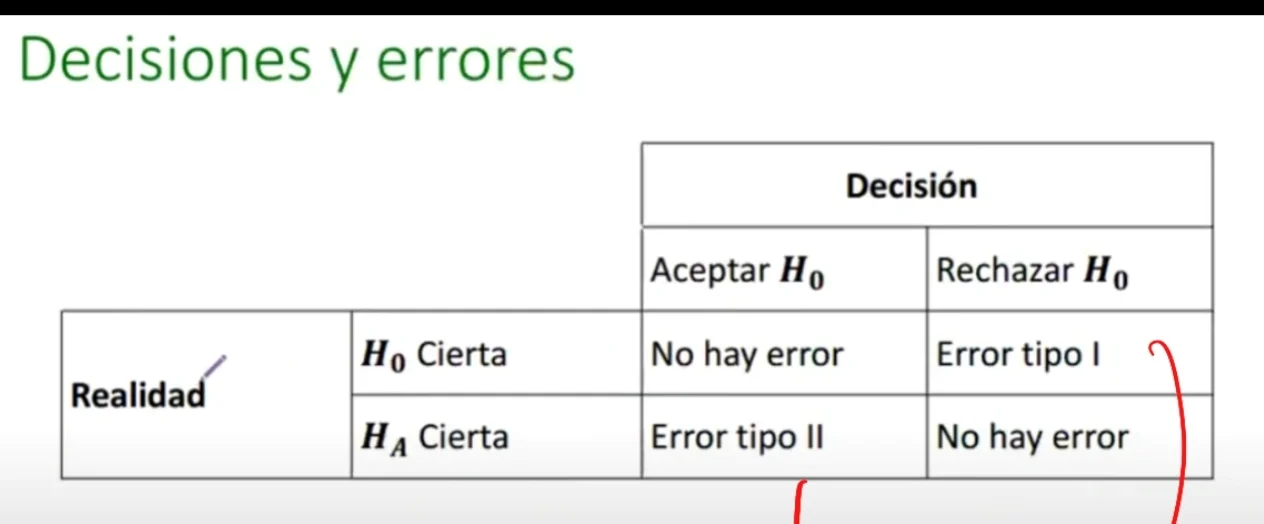
Pero no hay una ecuación que los ligue explícitamente, por lo que nos centramos en reducir el error tipo 1.
Luego de establecidas las dos Hipótesis vamos a tener que definir un estimador apropiado, que no depende de Parámetros desconocidos.
Y vamos luego a tener que establecer una Región de Rechazo, en consonancia con nuestro estimador, que nos permitan discernir si rechazar o no la Hipótesis Nula.
Si nuestro Estimador observado, (la estimación) pertenece a la Región de Rechazo entonces podremos rechazar la Hipótesis Nula.
Una forma de comparar distintos Test de Hipótesis es analizar su Potencia:
Un test es preferible a otro cuanto mayor Potencia tenga en el mismo Nivel de Significación.
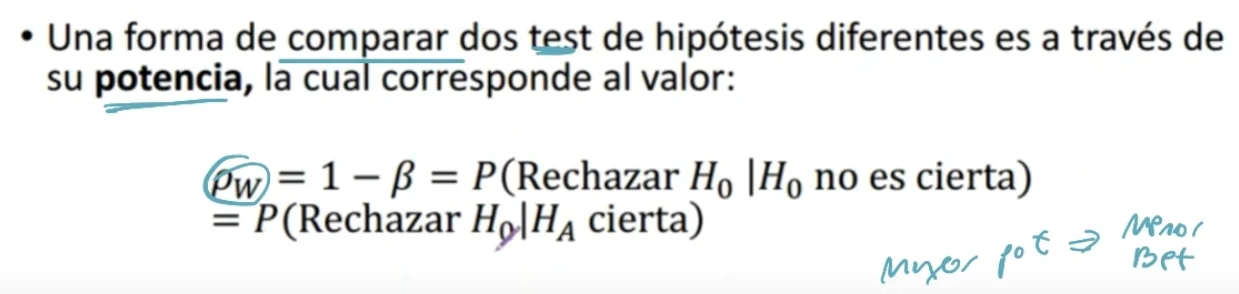
La Región de Rechazo es óptima para un Nivel de Significación fijo, si es la de mayor Potencia.
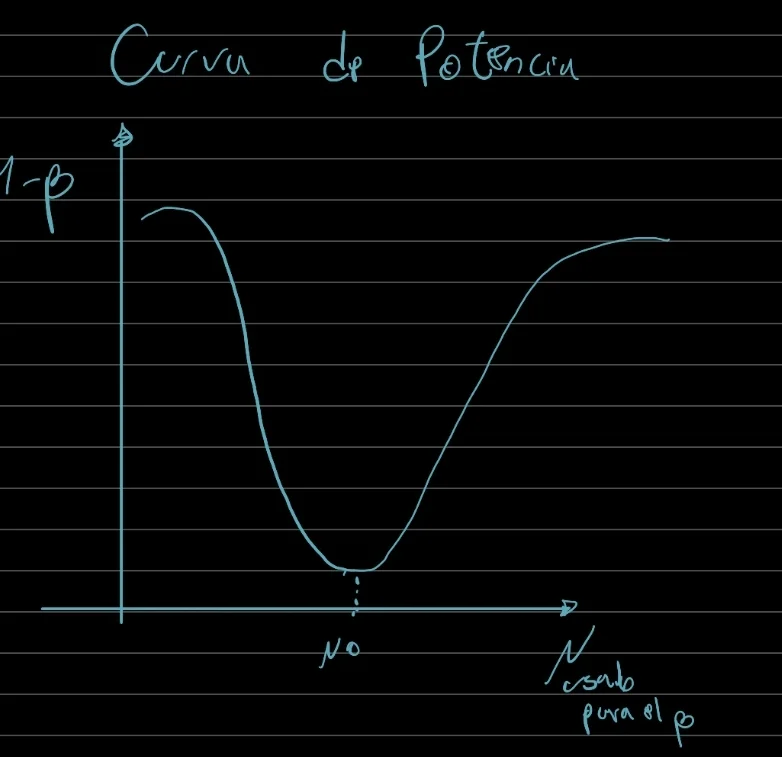
Para calcular la potencia se fija como el verdadero un valor distinto del Parámetros, y vemos cuánta área queda dentro de la región de confianza del test:
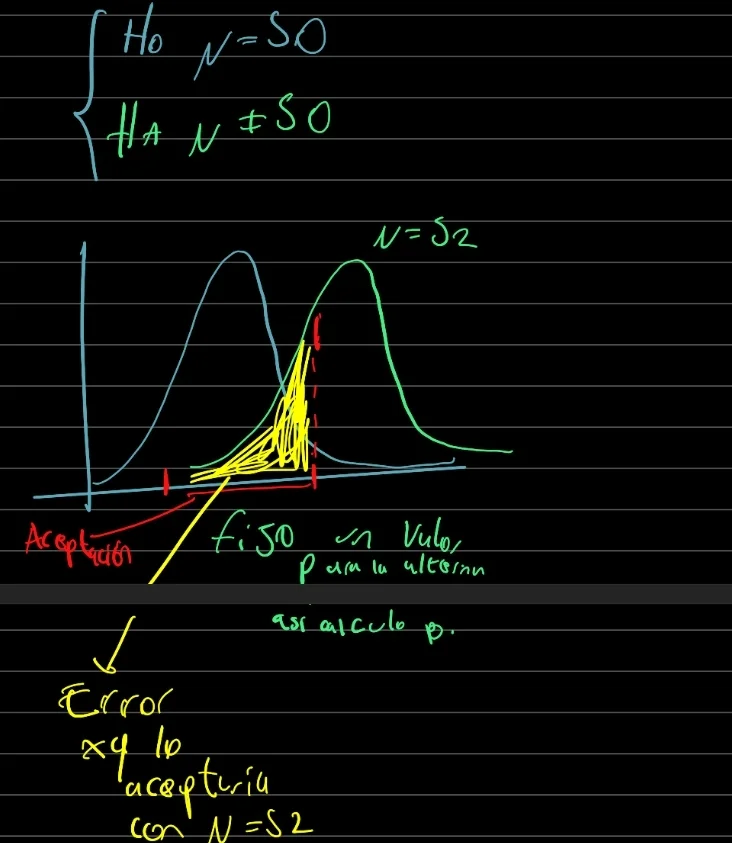
Como al ir cambiando el valor arbitrario cambia la Potencia, podemos definir una Curva de Potencia:
Además también está el P-valor que es la integral desde el e observado.
Rechazamos la Hipótesis Nula si el P-valor es menor al Nivel de Significación.
Si están hechos de forma bilateral, y con el mismo Nivel de Significación, un Test de Hipótesis tiene la misma conclusión que un Intervalo de Confianza.
Test para 1 Varianza
Si queremos saber si una Varianza puede ser tal valor, o mayor que tal etc. usamos este test:
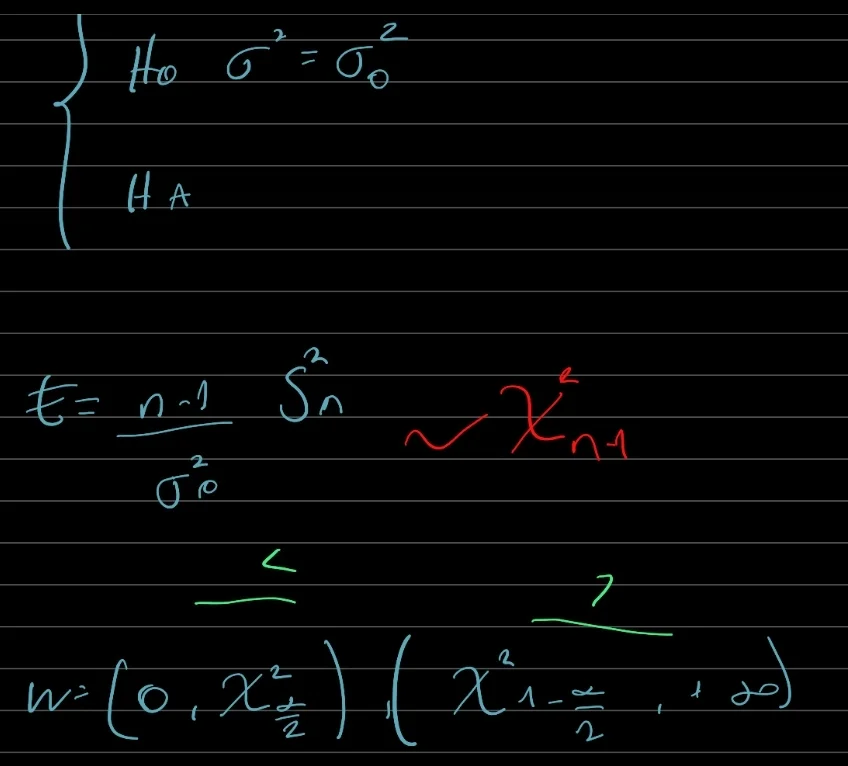
Test de Comprobación de P
El test de comprobación de p, se usa con una Distribución de Bernoulli que aproximamos aNormal por lo que queda:
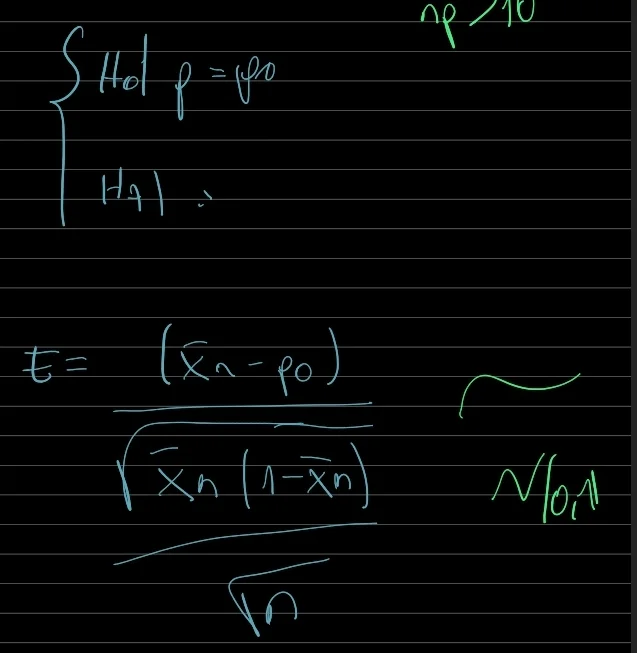
Igual a una Z.
Test de Homogeneidad de Varianzas
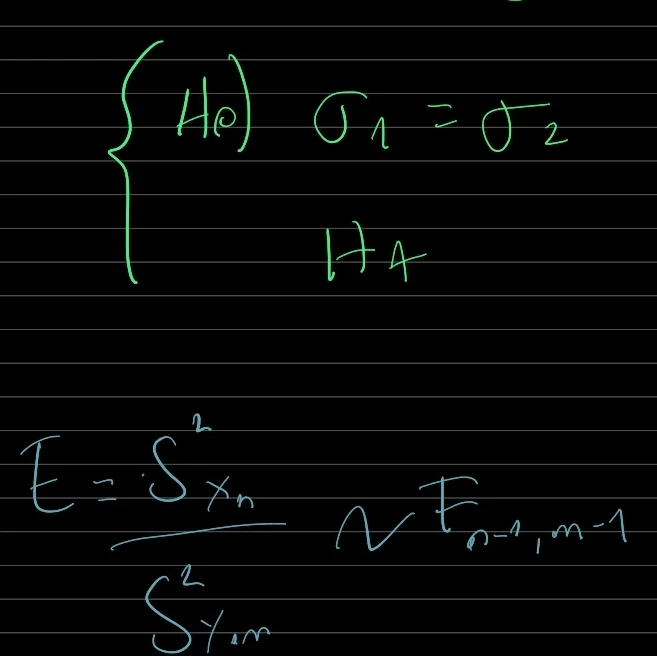
El Test de Homogeneidad de Varianzas, va a ser de los más usados, ya que muchas veces queremos saber si podemos considerar las Varianzas Homogéneas.
(Solo aplica si son desconocidas, si fueran conocidas usamos el de Varianza conocida.)
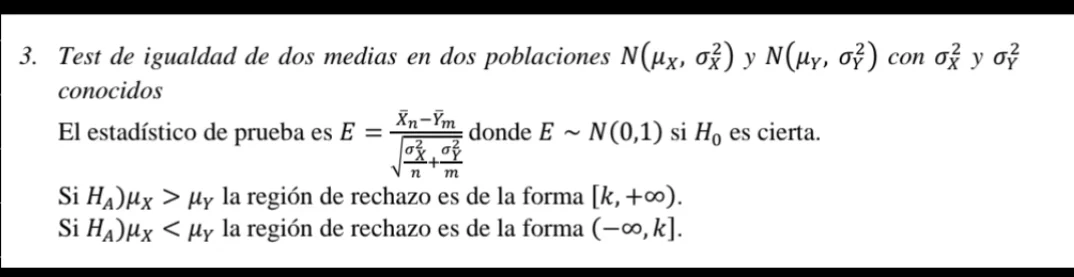
Test de Igualdad de Muestras Normales
Hay muchos dependiendo de las condiciones de trabajo, y del experimento, pero en todas requerimos que sean Normal.
Varianzas conocidas:
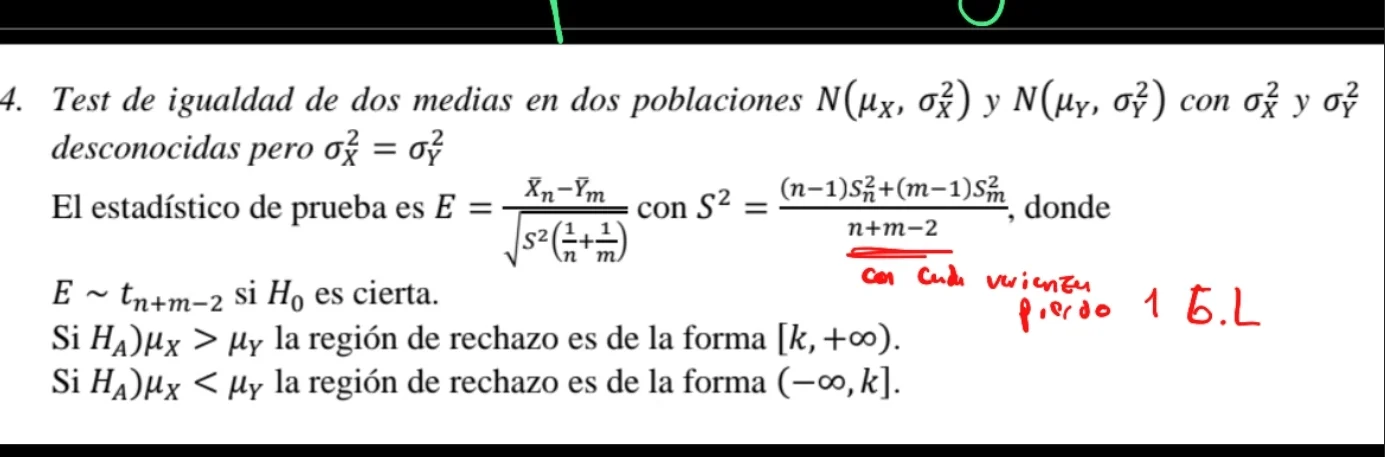
Varianzas desconocidas, pero homogéneas
Requiere haber hecho antes un Test de Homogeneidad de Varianzas.
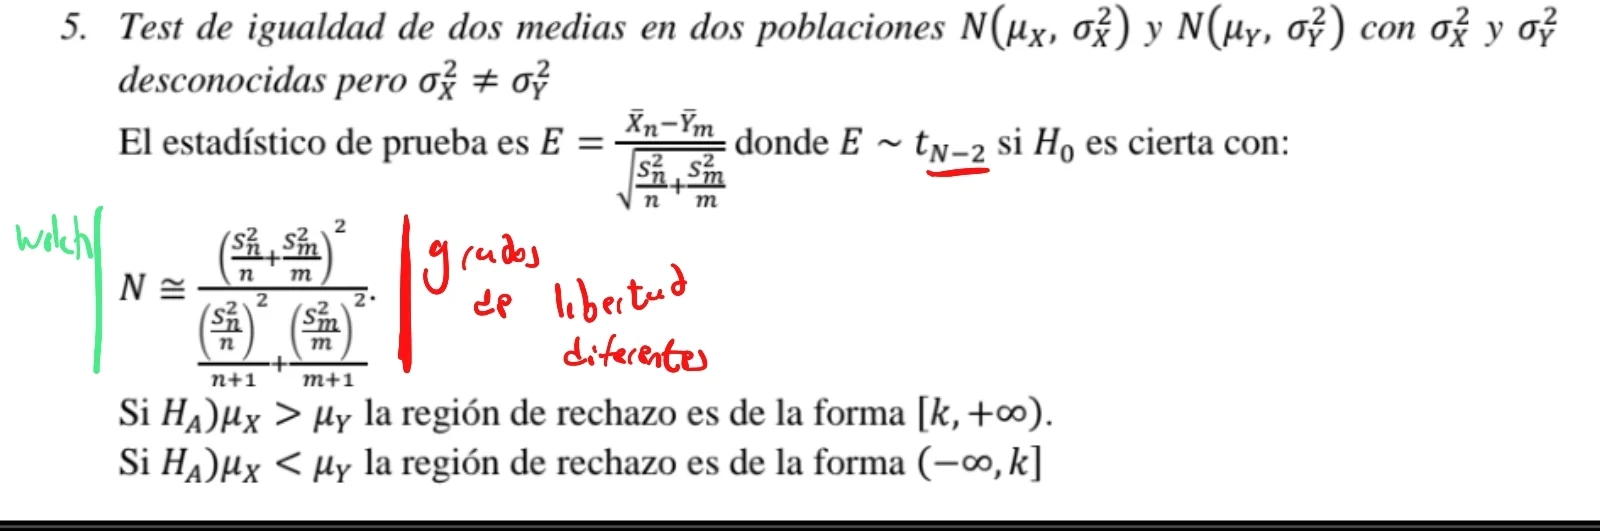
Varianzas desconocidas y no homogéneas
Test no Paramétricos
Hay test robustos, y sensibles, similar a Matemática 06, a los robustos no les pasa tanto si sus supuestos no se cumplen, por ejemplo la Normalidad. Pero a los sensibles si.
Por eso muchas veces requerimos saber si una Muestra Aleatoria tiene determinada Distribución. Es por ello que se usan los Test no Paramétricos.
Para Normalidad
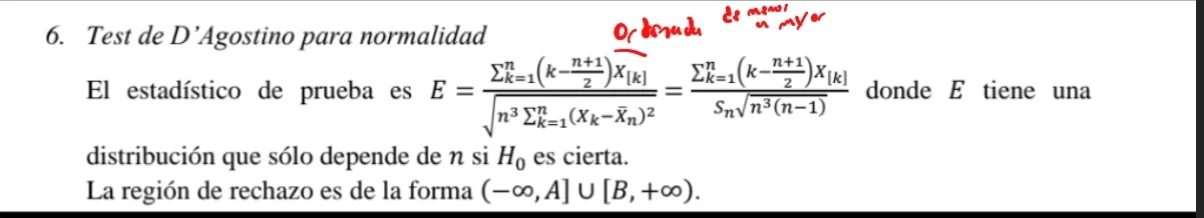
Test D'Agostino
El Test D'Agostino solo puede ser utilizado para la Normalidad:
Shapiro Wilks
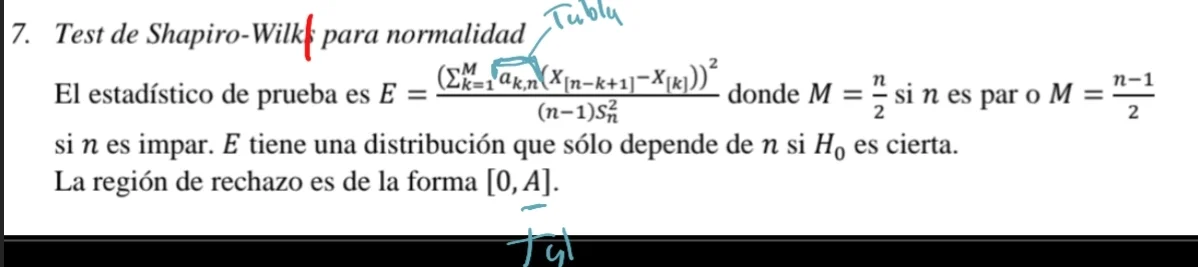
El Test de Shapiro Wilks es el que tiene mayor Potencia con muestras chicas, por lo que es el más utilizado.
Kolmogorov Smirnov
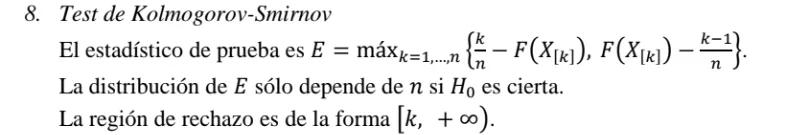
(Nosotros le vamos a dar todos los parámetros, y el solo nos dice si distribuye así o no. )
Multinomial
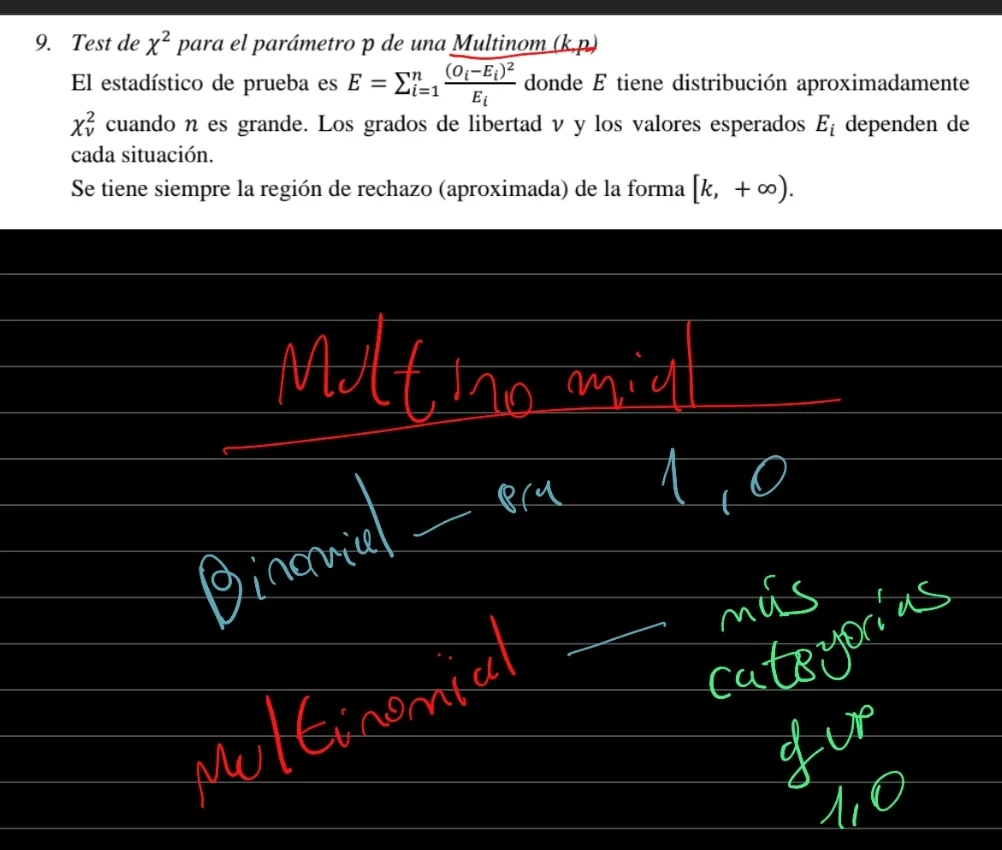
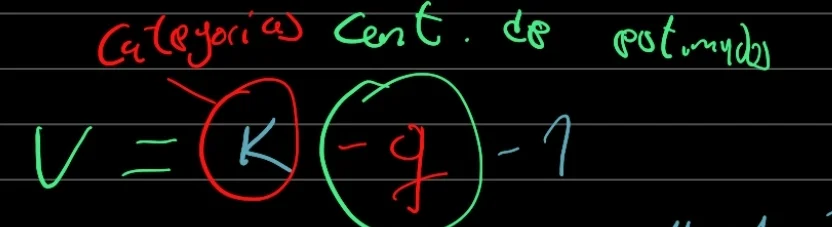
Y para los valores esperados, nos dan la frecuencia relativa esperada, entonces q es 0, o tenemos que sacarlo de una Distribución que tiene parámetros, entonces q será 1.
Es sensible a celdas con valores menores a 5, por lo que debemos agrupar más aún si nos quedara alguna celda con dicha condición.
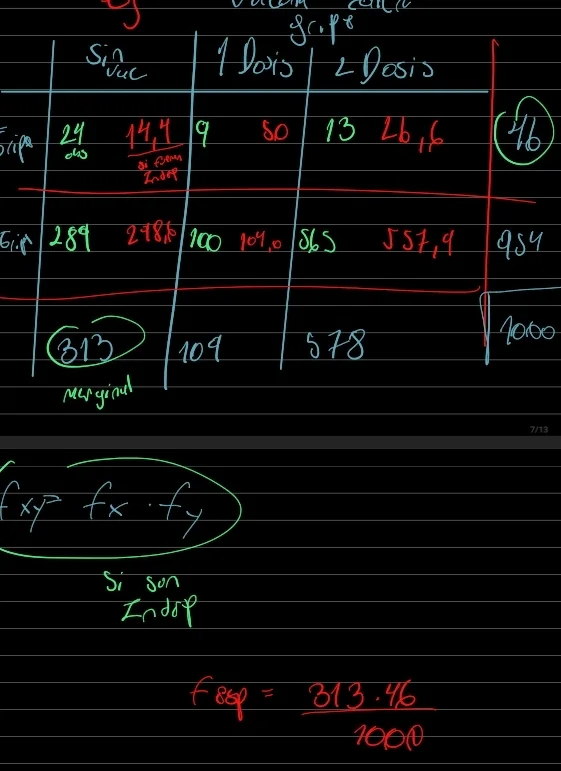
Independencia de variables u homogeneidad de muestras:
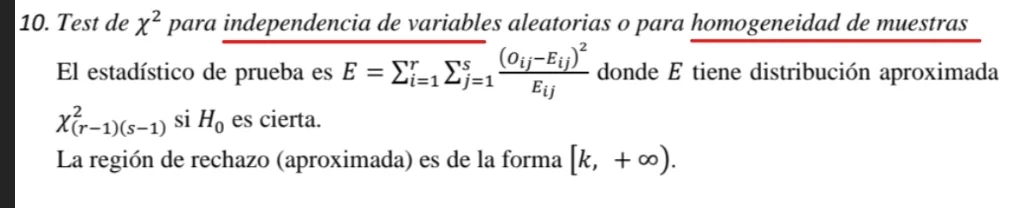
Hay que hacer una tabla (Los esperados se calculan con regla de 3).
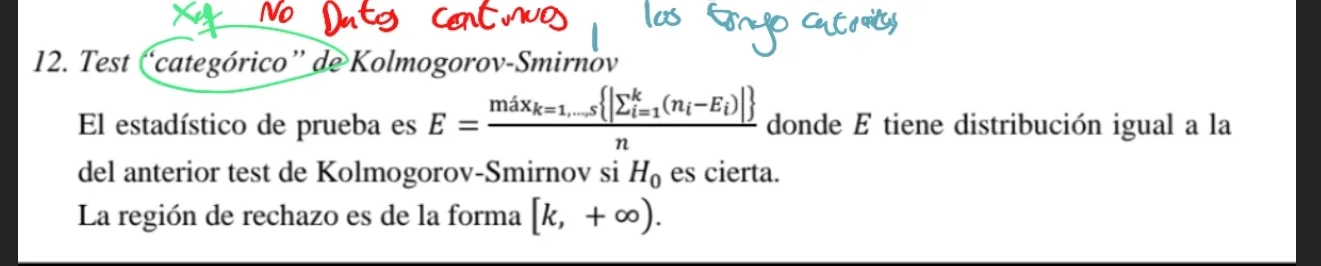
Test Categórico de Kolmogorov Smirnov
Modelo de Regresión Lineal
En la Regresión Lineal, vamos a tener 2 tipos de Variable:
- Variable Predictoras
- Variable de Respuesta.
Variable Predictora podemos tener 1 o más, pero de respuesta solo 1.
Si tenemos una sola predictora estamos en un modelo de Regresión Lineal Simple.
Este modelo se basa en hacer varias observaciones de un experimento, y construir la Recta que mejor ajuste a esos puntos.
Al provenir de un experimento, no nos podemos olvidar que cada punto viene de una Distribución.
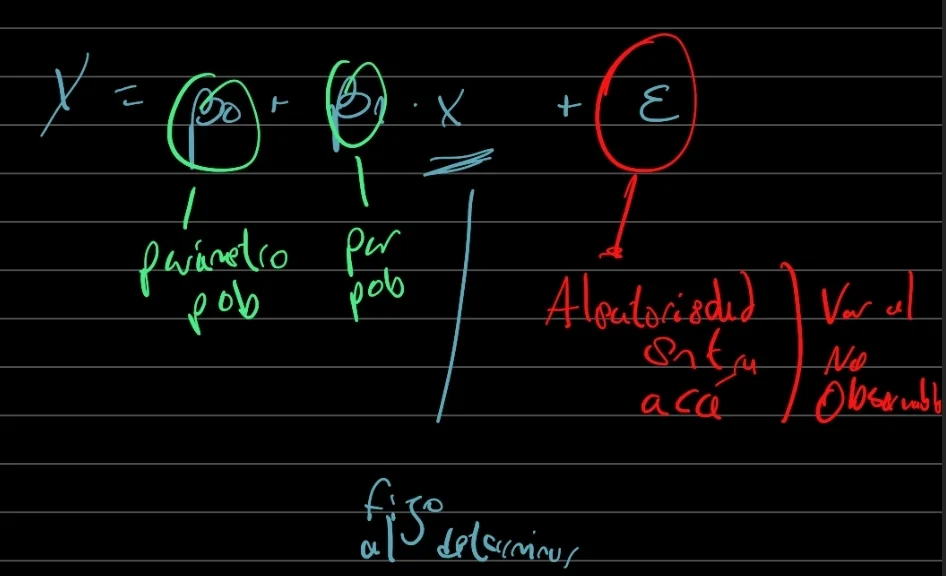
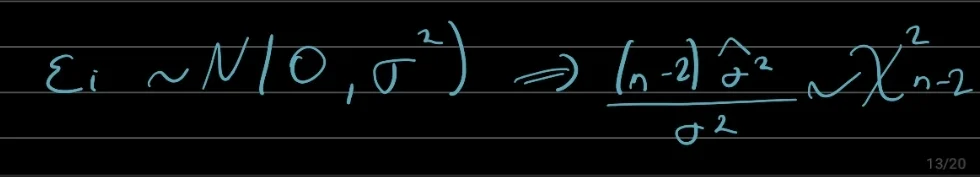
Esa aleatoriedad entra en el epsilon. Que si todos los supuestos se cumplen, distribuye Normal, de mu 0 y Varianza sigma cuadrado, y son Independientes.
Con eso, cada Yi distribuye Normal:
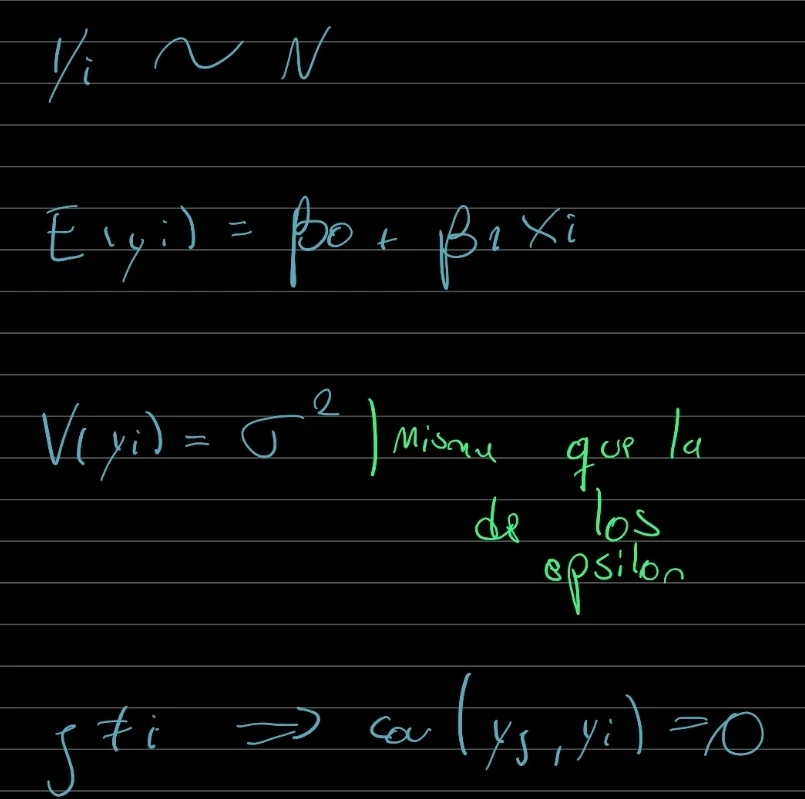
Para construir esa recta, necesitamos estimar Bo y B1
Por lo que vamos a construir el siguiente Sistemas de Ecuaciones Lineales:
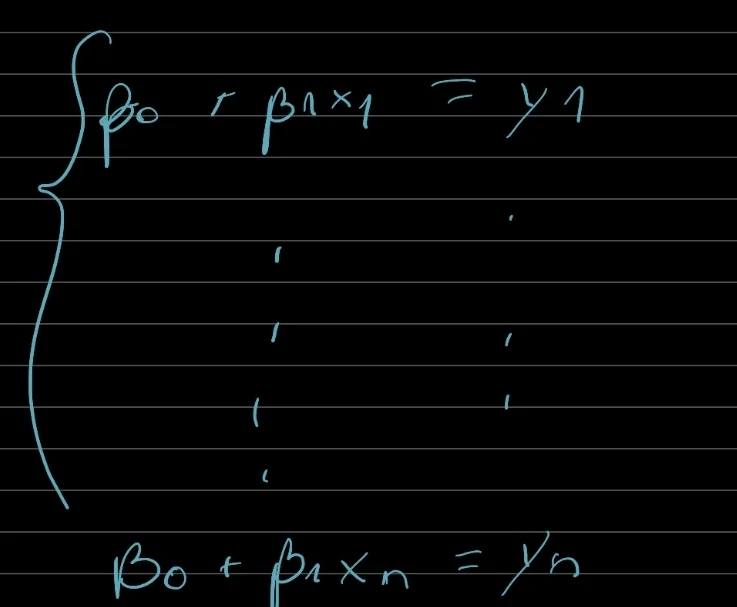
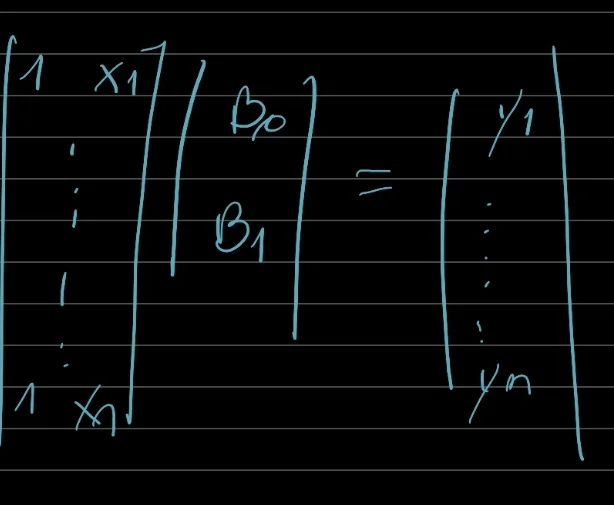
Y lo podemos resolver de usando Matrizes:
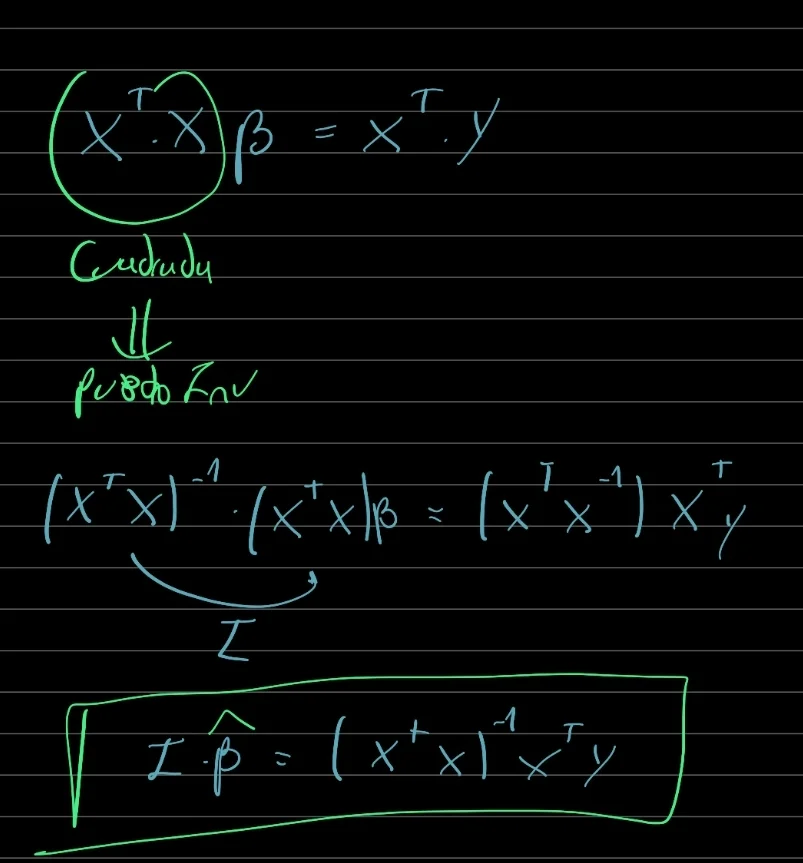
O por Aproximación por Mínimos Cuadrados, que nos deja:
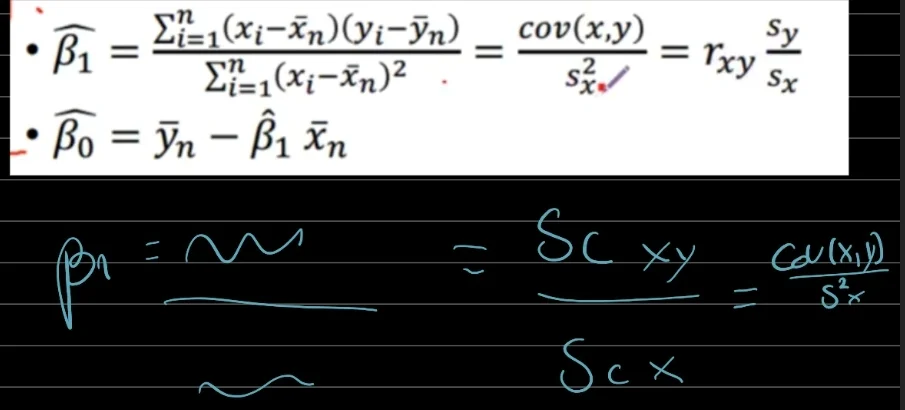
Hay veces que el B0 no tiene interpretación en la realidad, pero lo dejamos para usar la mejor Recta.
Otras veces, si queremos usar el modelo en x=0, y el sentido real es que B0 sea 0 podemos forzarlo, pero ya no usamos la mejor recta.
NO es recomendable Extrapolar porque puede que cambie el comportamiento del experimento y no lo sepamos.
Bo y B1 también son Variables aleatorias, por lo que tendrán su Esperanza y Varianza:
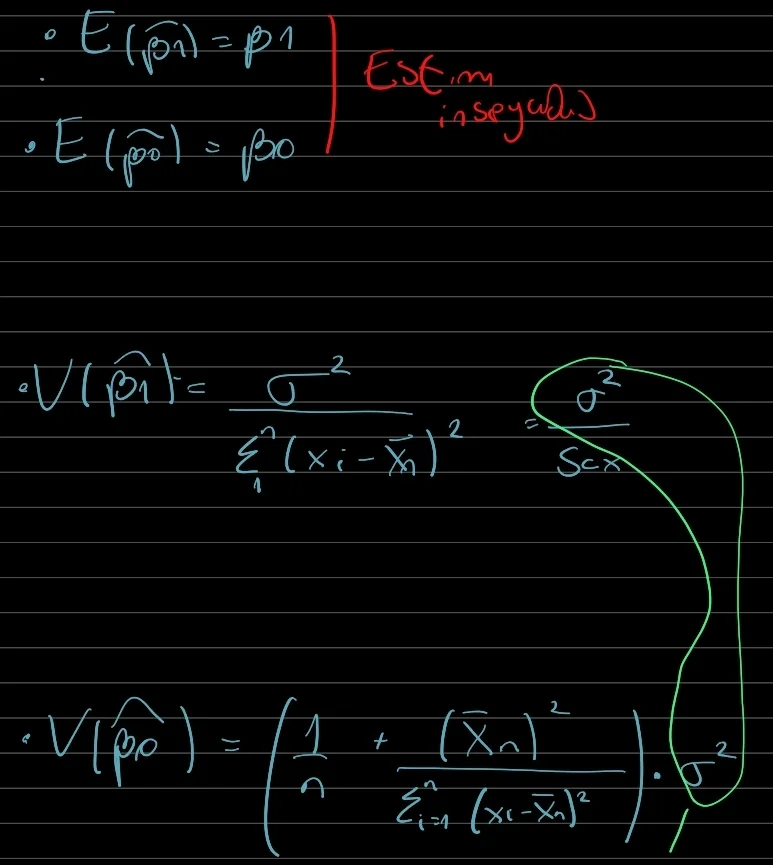
Pero sabemos que son insesgados y de Varianza mínima.
También podremos estimar sigma cuadrado como una Varianza Muestral pero con 1 Grados de libertad menos:
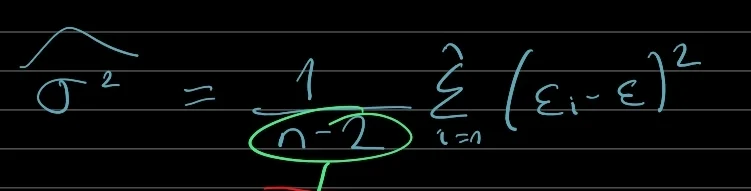
También es insesgado e independiente de los b.
Podemos descomponer la variabilidad e y en 2.
La que podemos explicar con el modelo y la que no.
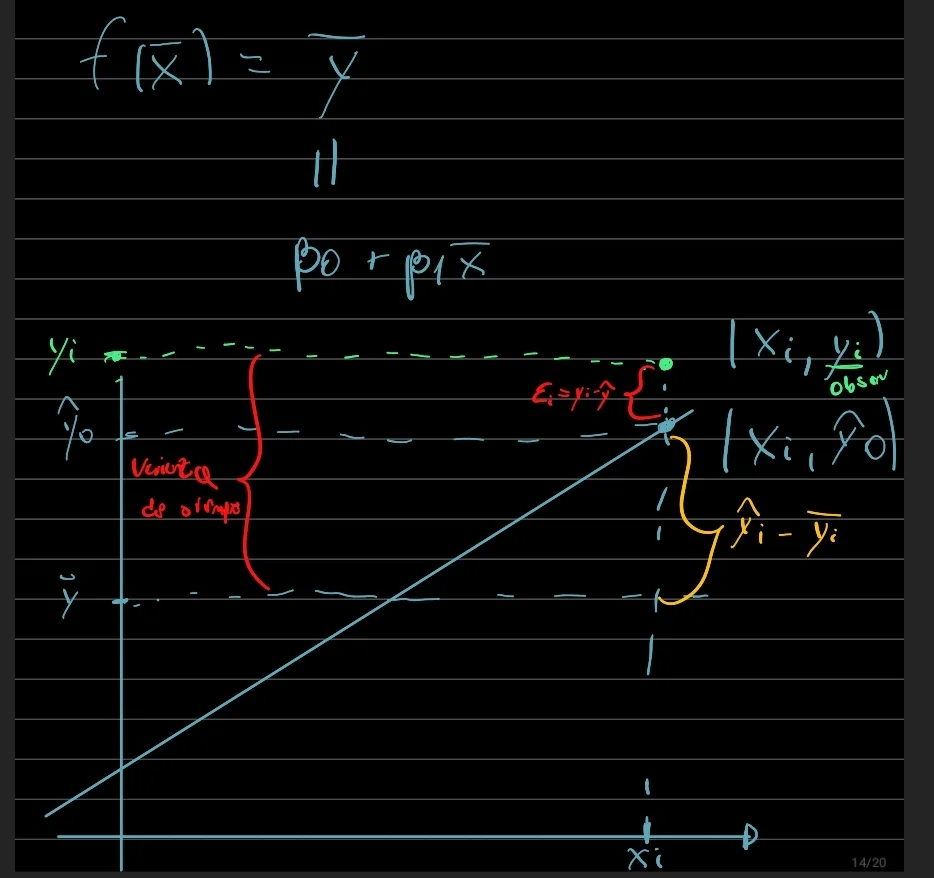
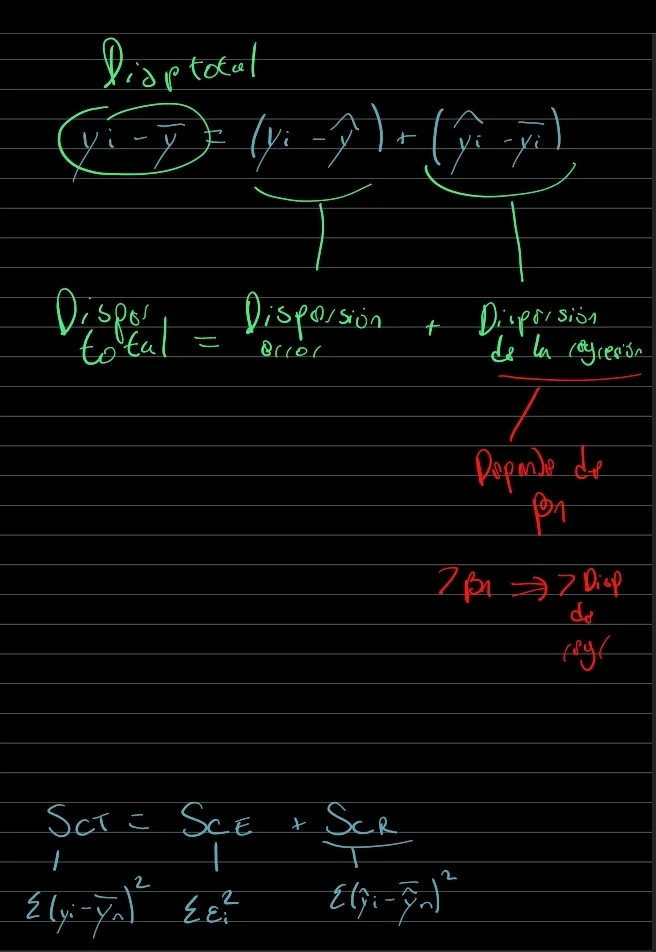
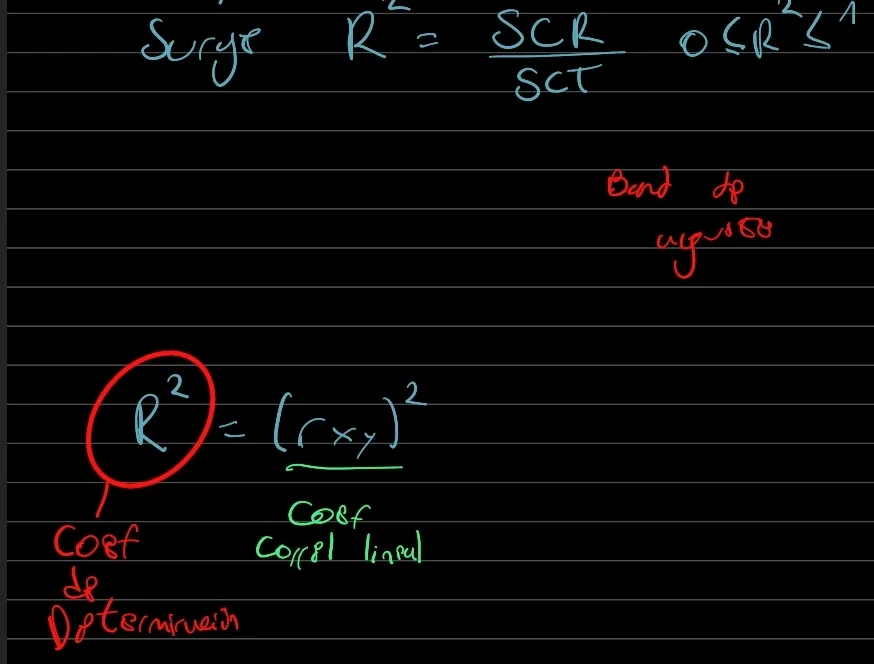
En el modelo ideal podríamos explicar todo con el modelo, y el SCE sería cero, pero como nunca pasa, surge R2 para poder ver que tan cerca estamos:
También podemos hacer un Test de Hipótesis para B1, que nos va a indicar si está bien haber usado el modelo.
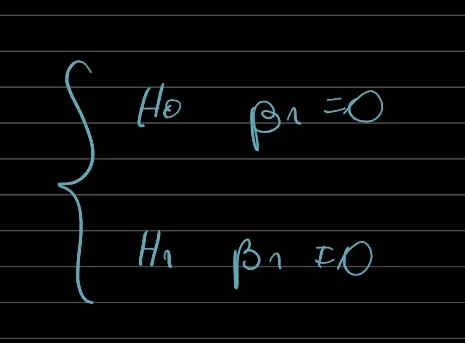
Y para hallar el Estimador fácilmente podemos usar una Tabla Anova.
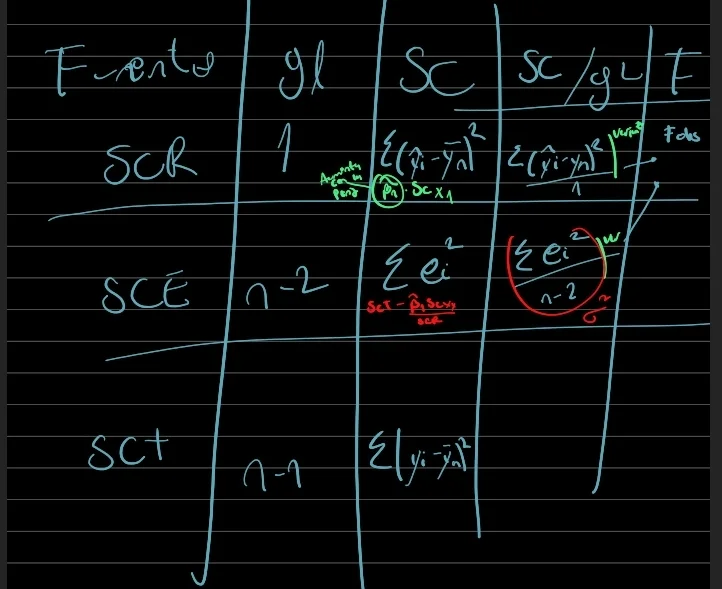
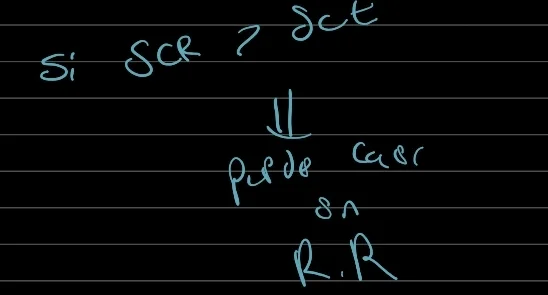
También hay otro Test de Hipótesis para B1 que usa la aproximación a la Normal:
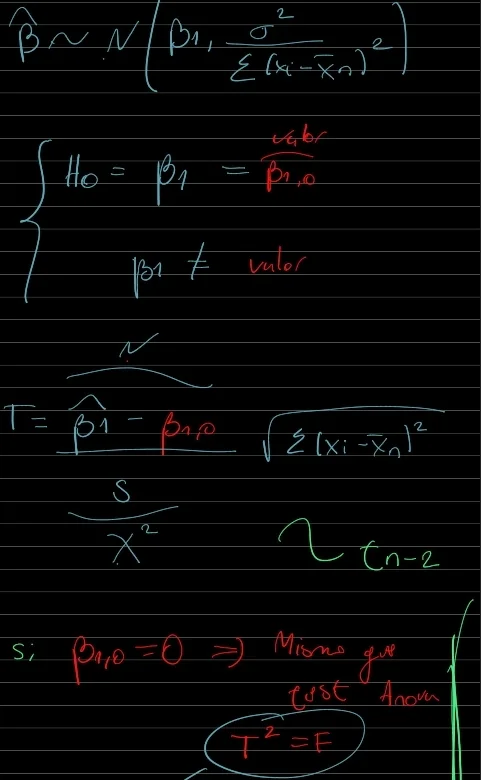
Se puede hacer lo mismo para B0 pero en general no interesa.
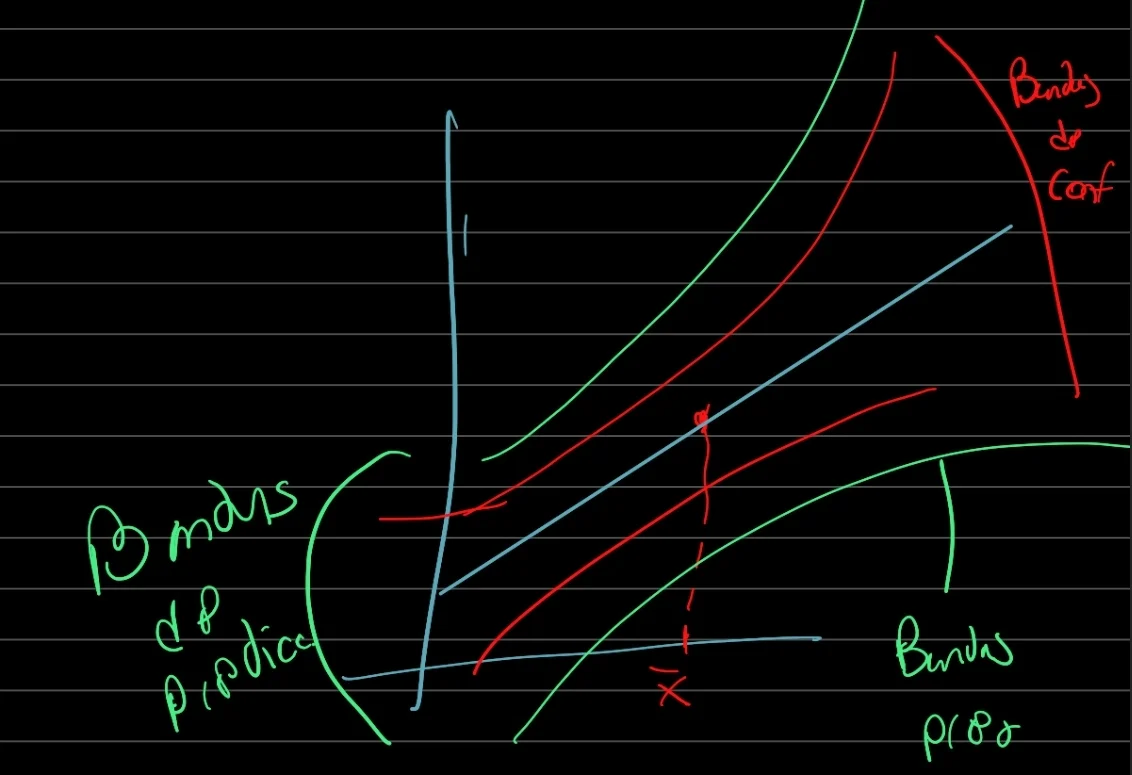
Gracias al modelo podemos estimar la Respuesta Media en un punto, o predecir una observación nueva:
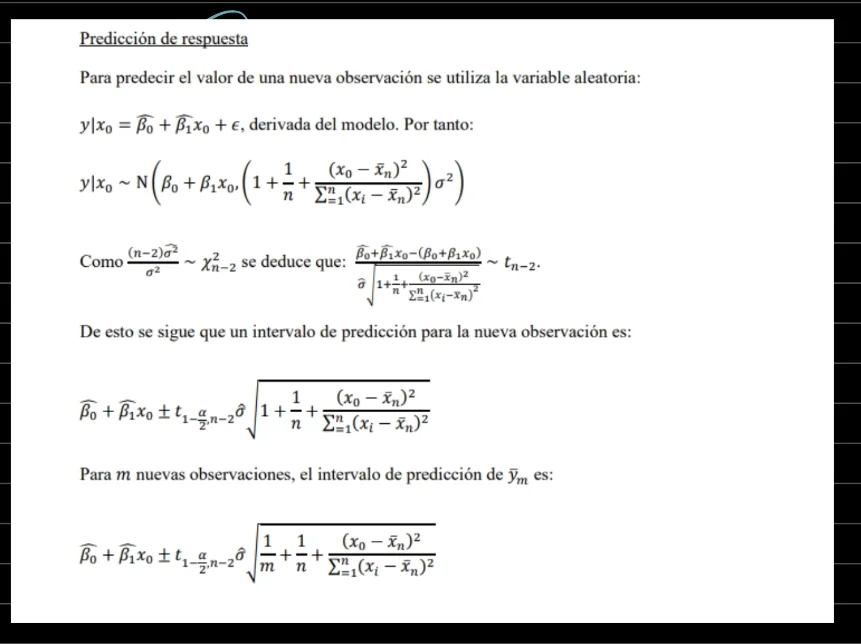
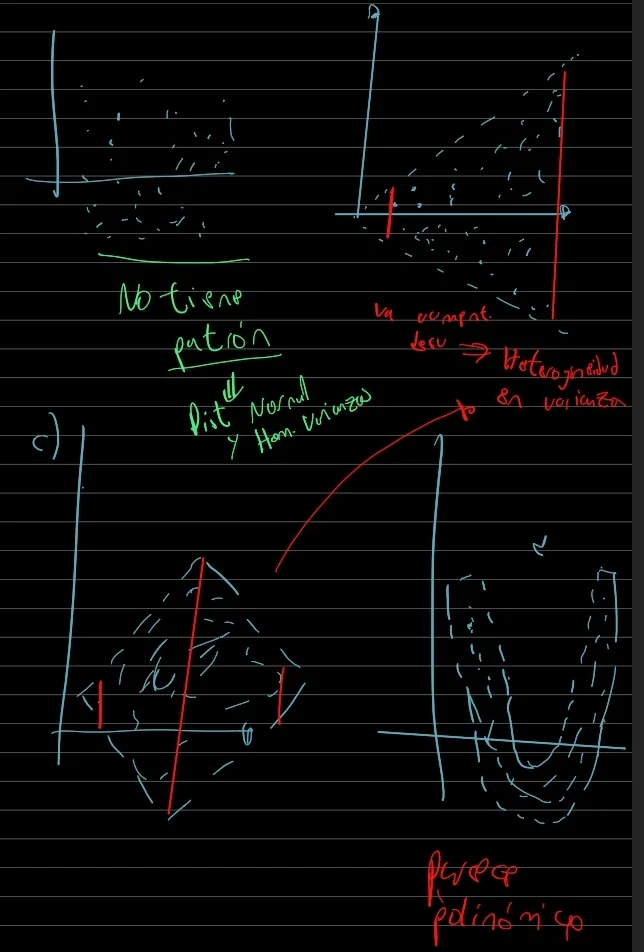
Residuos Vamos a llamar residuos a las diferencias entre la observación con el modelo, habíamos supuesto que distribuían Normal, eran independientes y de Varianza Constante.
Pero podemos chequearlo con Test de Hipótesis, o Gráficos.
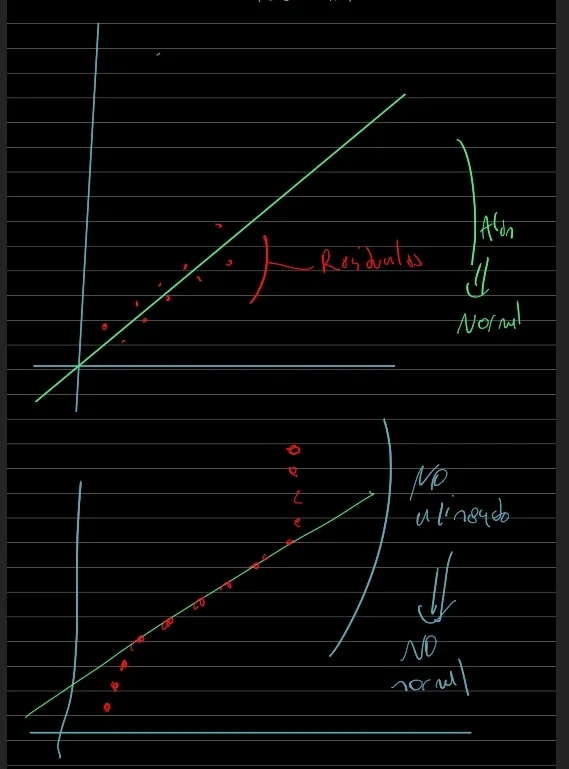
También podemos hacer un QQ plot, que ordena de menor a mayor los Residuales, si queda una recta, podemos decir que parece distribuir Normal, pero con curvas raras debemos sospechar:
O también un Histograma de los Residuales.
Regresión de varias Variables
Al hacer una regresión de varias variables, vamos a tener que estimar más Parámetros.
Los supuestos a cumplir se mantienen, y el método de cálculo con Matrizes también.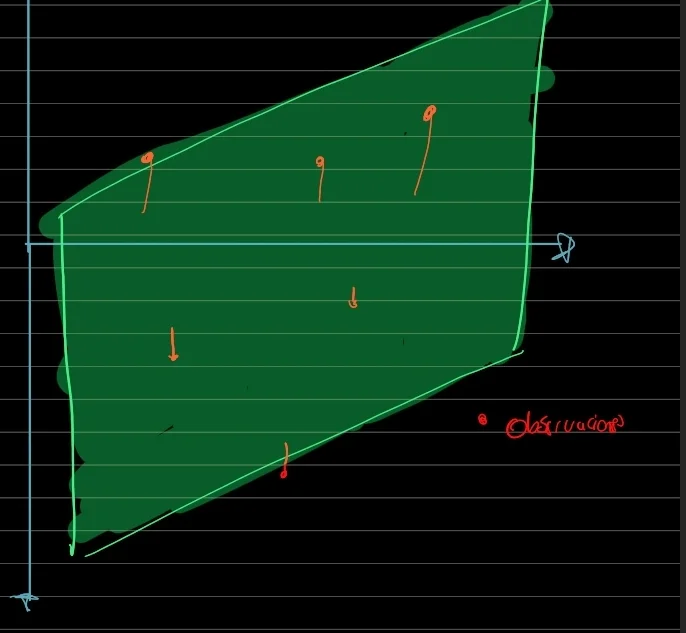
Las que más van a cambiar son las Varianza:
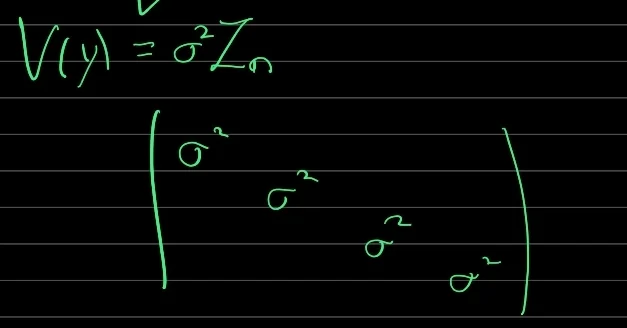
También puede ser que tengamos columnas que no sean Linealmente Independiente, lo que va a impedir que podamos invertir la Matriz.
También los Residuales, y cada Parámetros siguen siendo Variables aleatorias:
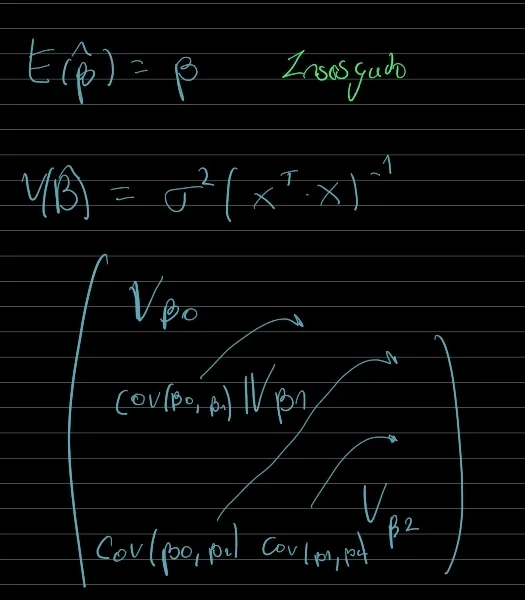
El Teorema de Gauss Markov demuestra que los B así estimados son insesgados y de Varianza Mínima, por lo que serán la mejor forma de estimarlos.
También la Varianza, solo que ahora le restamos 1 y el número de variables:
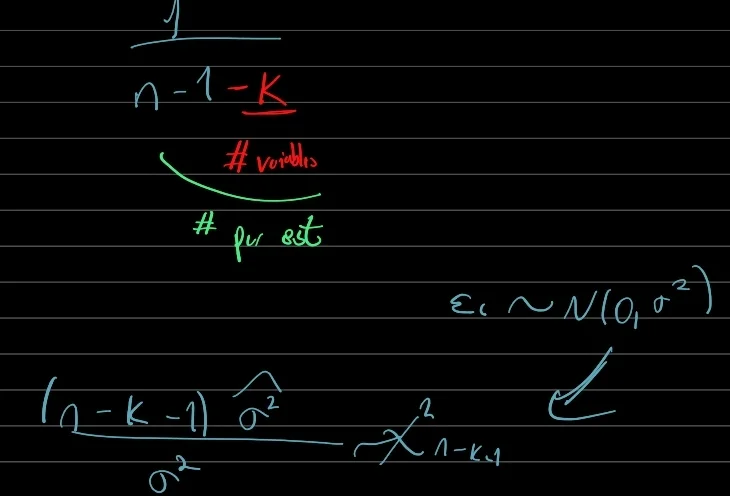
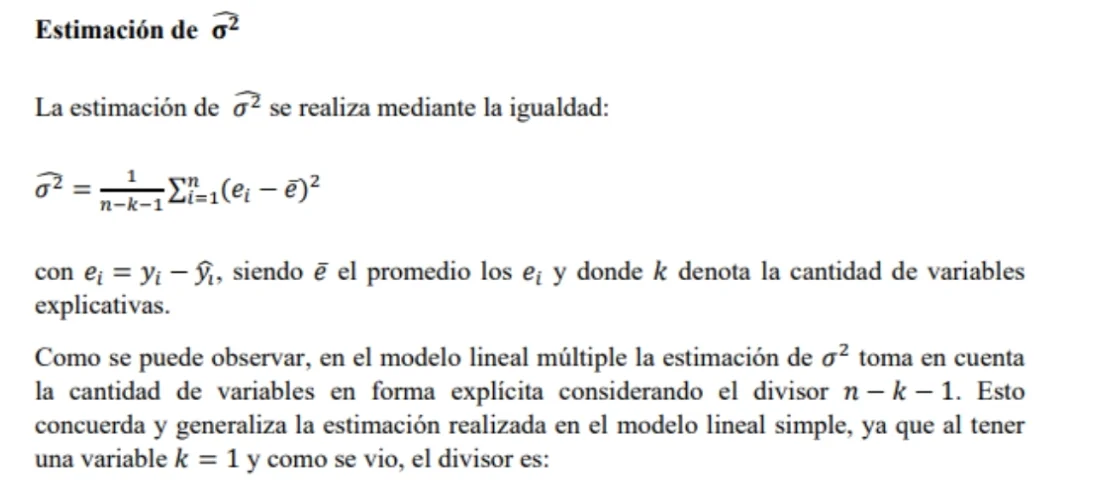
La Descomposición de variabilidad también se mantiene igual.
Y la Tabla Anova solo que ahora cambian los Grados de libertad.
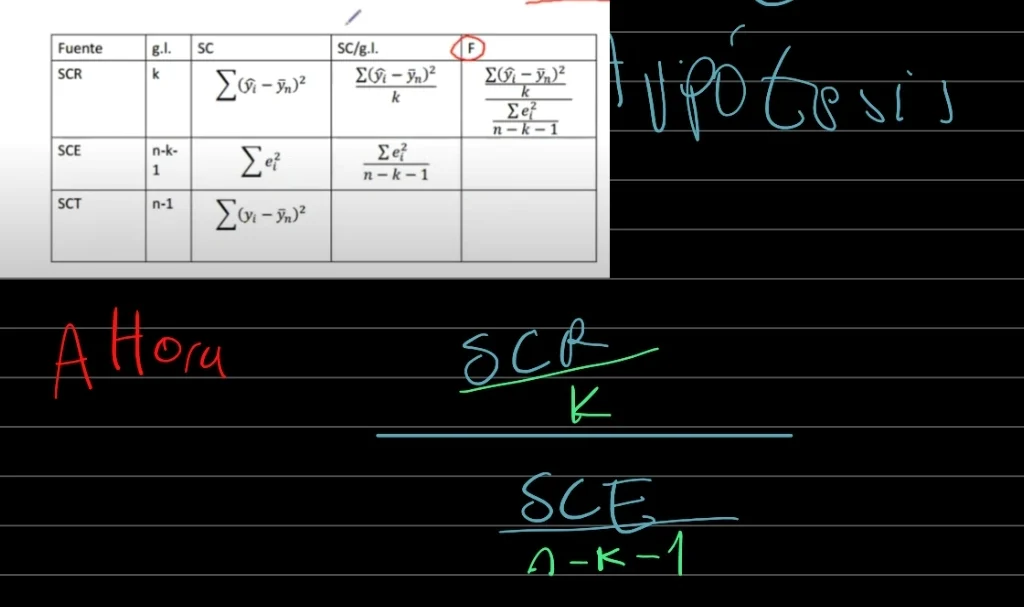
También podemos calcular R2 pero con cuidado, ya que si añadimos más variables, no va a bajar su valor, aunque la nueva variable no tenga nada que ver con y, por lo que no es útil así como medida de la Bondad de Ajuste.
Pero podemos ajustarlo:
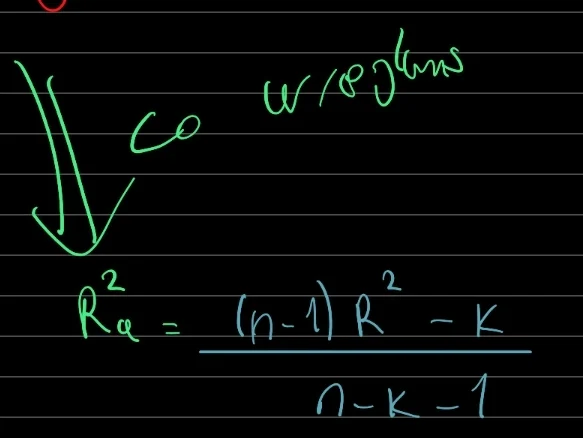
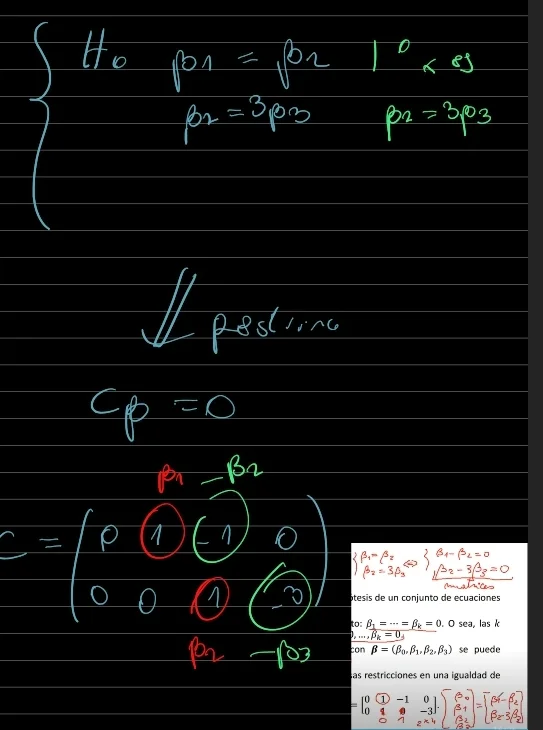
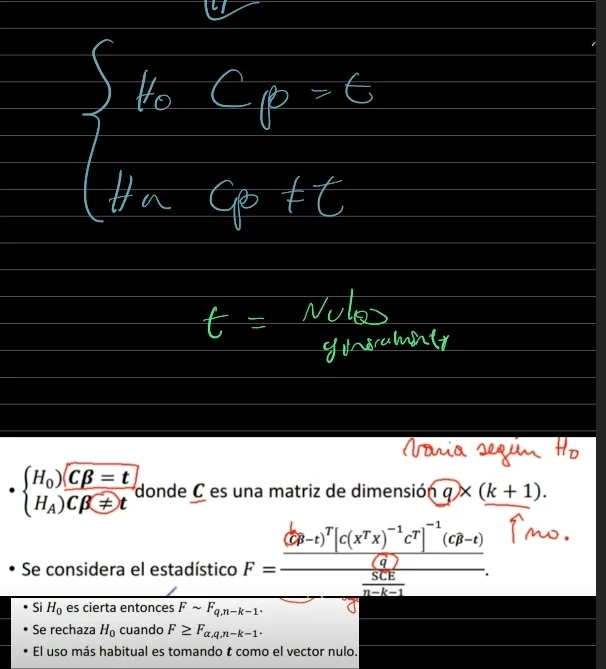
También hay un Test de Hipótesis para compara B entre ellos:
Test Anova
Los Test Anova son modelos de comparación de Varianzas. Entre grupos o categorías, por lo que son Discretas de por si.
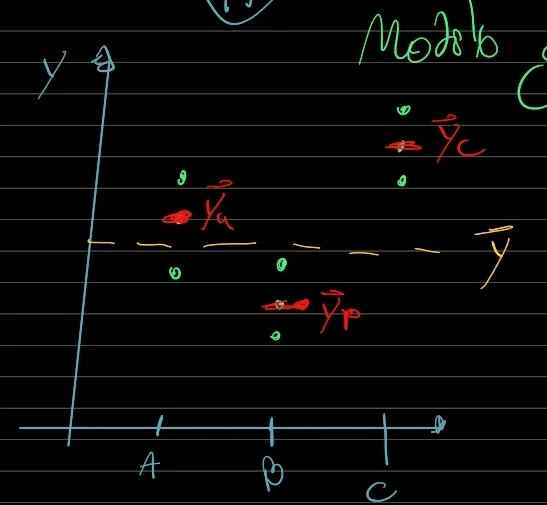
Se usa para medir si hay diferencias significativas entre los Promedios de cada categoría.
Hay dos fuentes de variabilidad, la que se da entre las ydea, y entre los promedios con el promedio general.
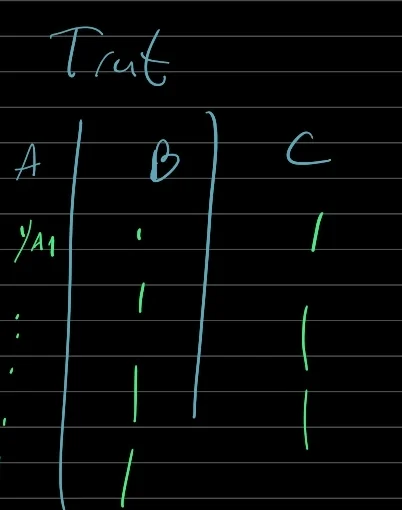
Puede haber tamaños diferentes entre los tratamientos.
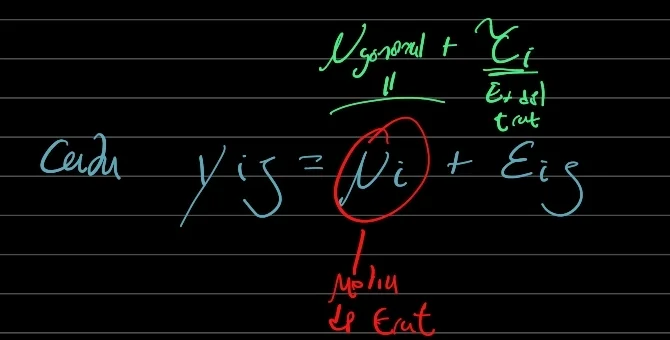
El Test de Hipótesis es:
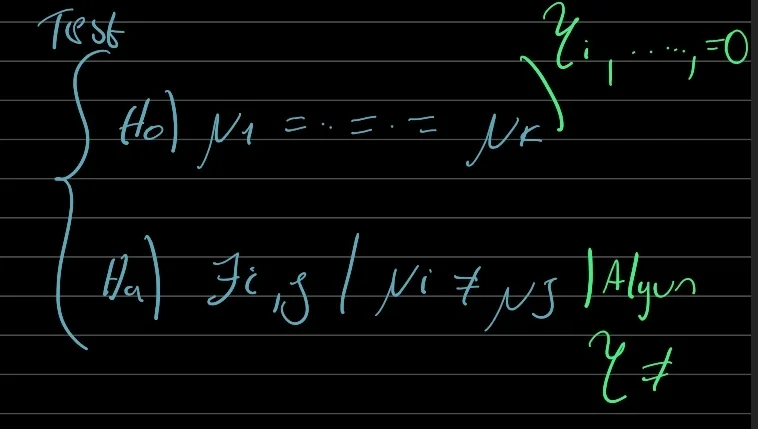
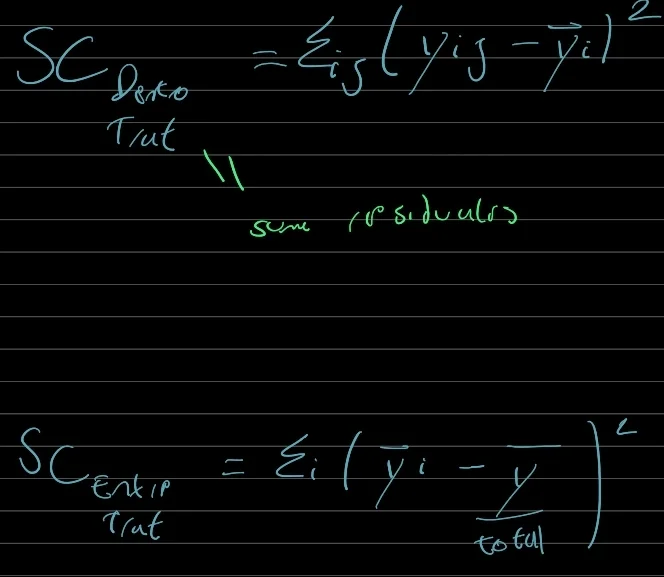
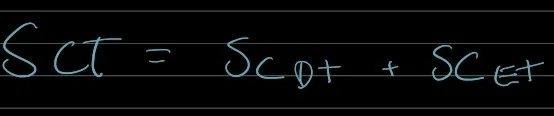
Y si se cumplen todos los supuestos, el cociente de varianzas distribuirá Normal.
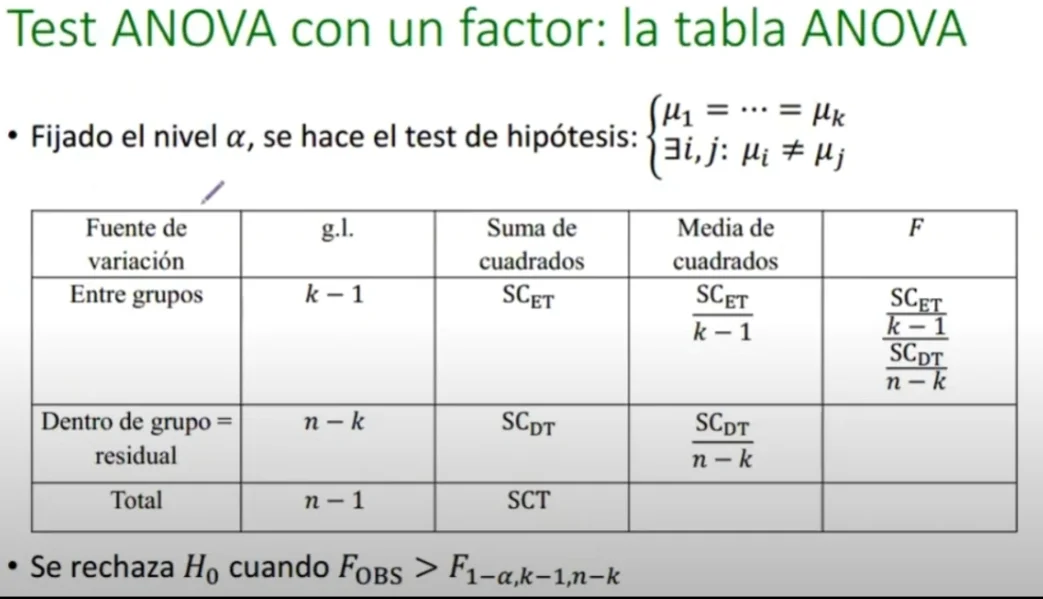
Siendo k el numero de categorías.
k fuera 2, estamos haciendo lo mismo que en un Test de Homogeneidad de Varianzas con t. y t2 es igual a f.
También podemos hacer Test Anova con 2 factores, analizando el efecto de 2 categorías, aunque en realidad se suele usar más para analizar el de 1, sin que afecte la variabilidad de la otra, por ejemplo edad de los ratones o lugar del campo etc.
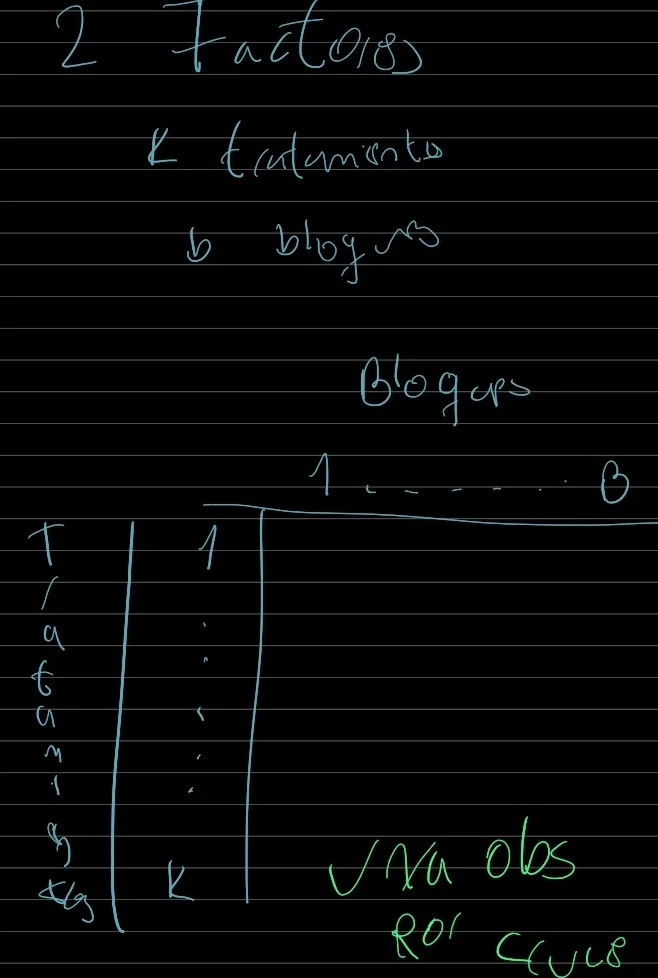
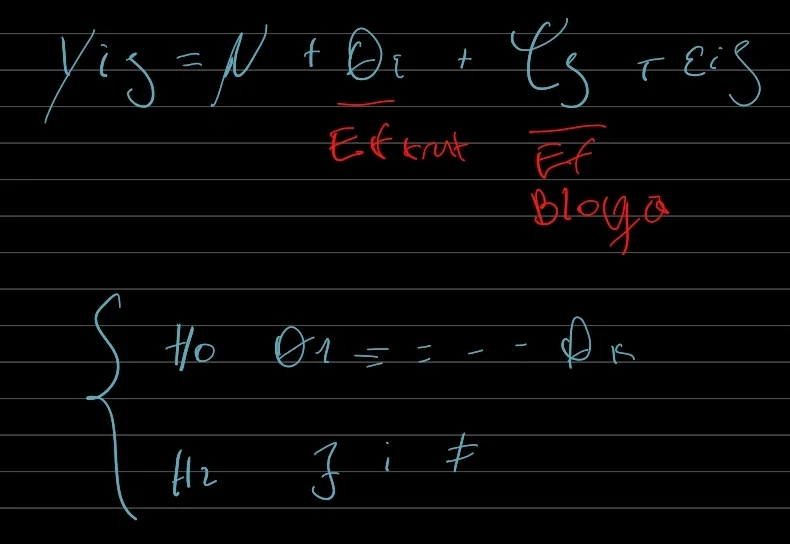
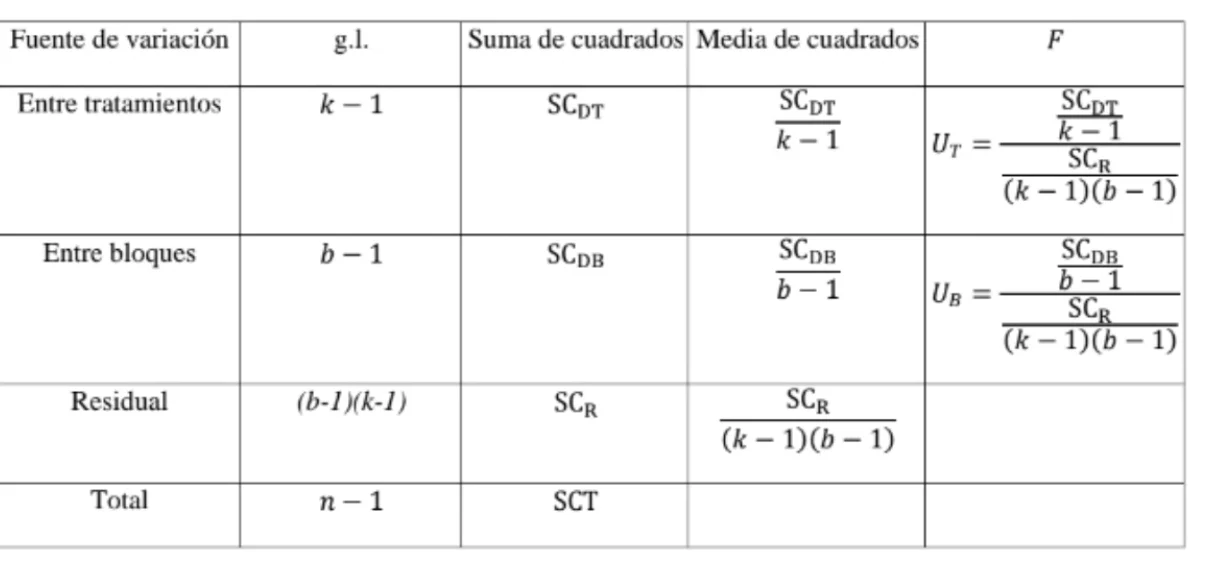
Nuevamente se construye la Tabla Anova:
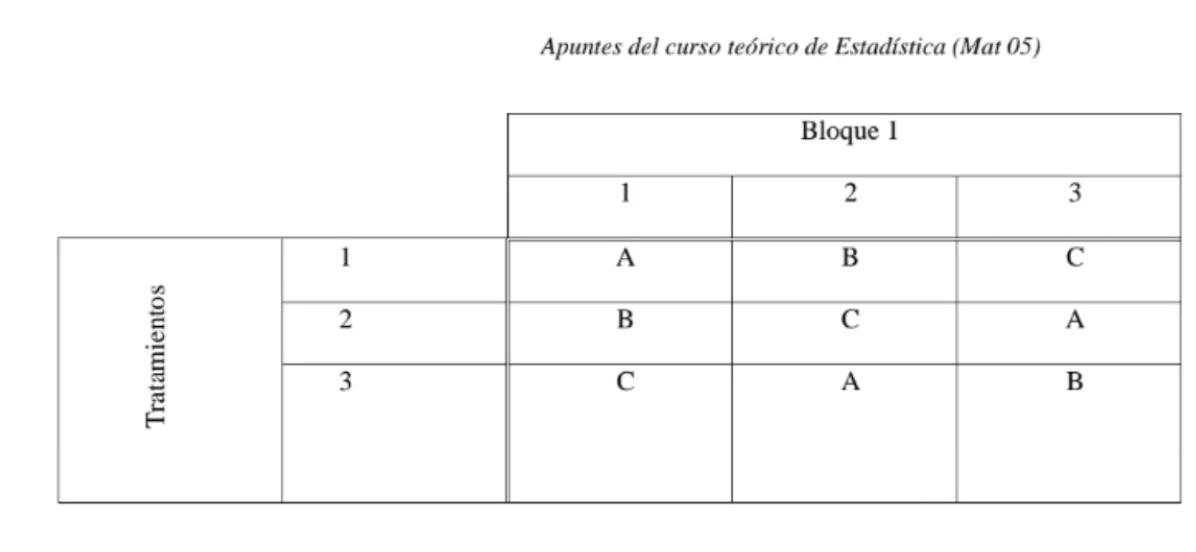
Y finalmente de 3 factores, o Cuadrado Latino.
El problema es que solo puedo probar 1 sola letra por cruce:
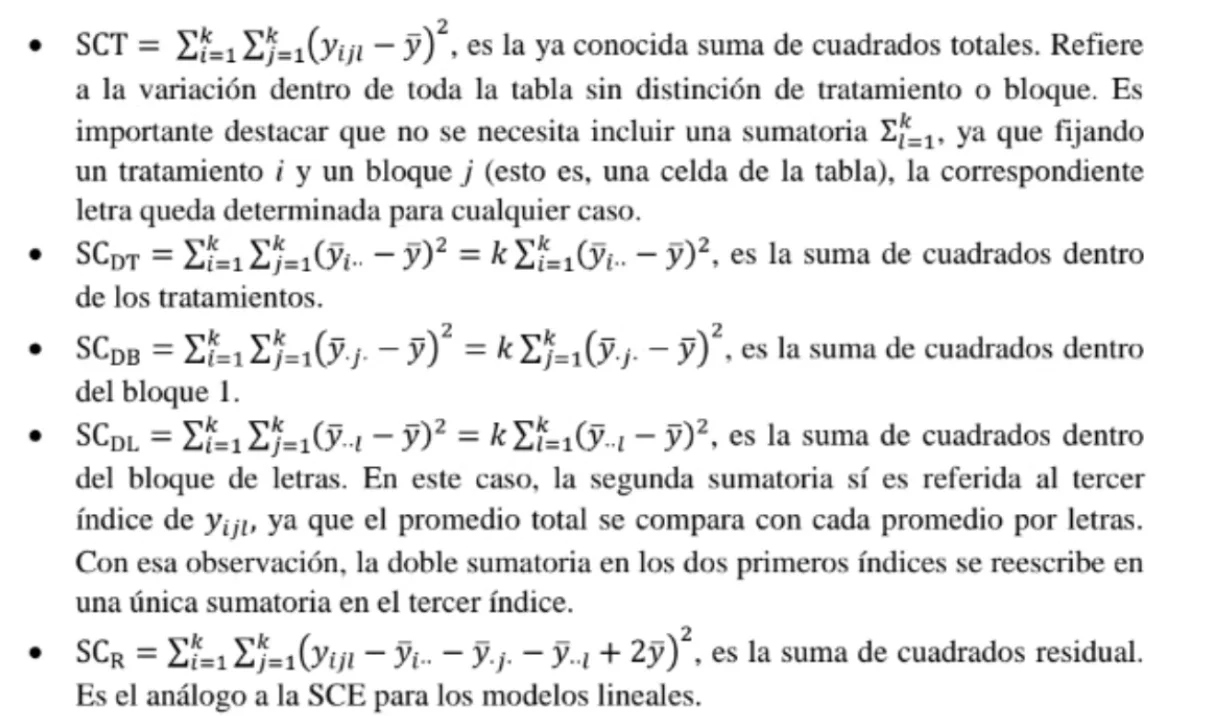
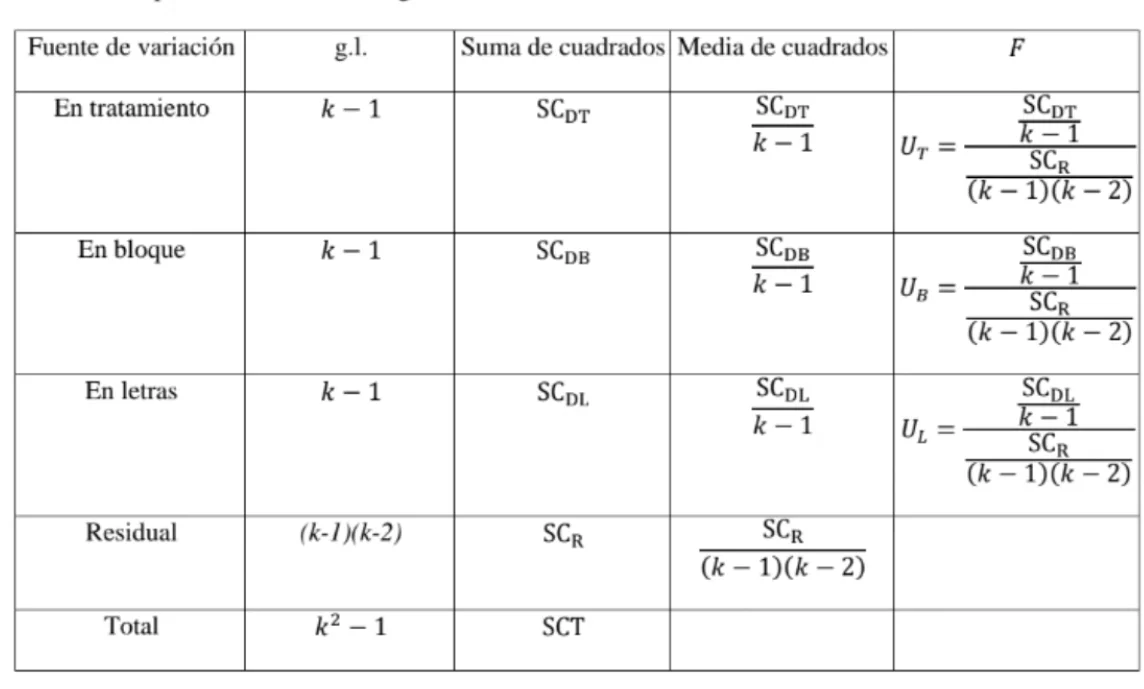
Y nuevamente se puede hacer una tabla anova: