Matemática 05 1
Probabilidad
Un Experimento es el proceso de obtener observaciones de un fenómeno aleatorio.
Un fenómeno es Aleatorio cuando no se puede predecir de forma exacta lo que se va a observar.
El Espacio Muestral es el Conjunto de todos los resultados posibles para el Experimento
Un Suceso es cualquier Subconjunto del Espacio Muestral.
Para expresar que sirve que pase uno u otro se usa la Unión, y si deben pasar los dos a la vez, la Intersección.
Si quiero la no ocurrencia trabajo con el Complemento.
El Suceso que es un Conjunto Vacío, equivale a un suceso imposible, se obtiene a partir de condiciones que no cumple ningún elemento del Espacio Muestral.
El Suceso seguro es el Suceso que contiene a todo el Espacio Muestral.
Dos Sucesos son Disjuntos si su Intersección da el Conjunto Vacío.
Enfoque Frecuentista de la Probabilidad
El Enfoque Frecuentista de la Probabilidad se basa en la repetición de Experimentos Idénticos.
y definir la Probabilidad como la frecuencia relativa con la que ocurre el evento:
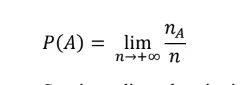
Pero requeriría de infinitos Experimentos, lo que obviamente no es realizable.
Enfoque clásico
El Enfoque Clásico de la Probabilidad se aplica en Experimentos con Espacio Muestral finito, donde cada elemento además, es equiprobable.
Para calcular las Probabilidades usaremos los Cardinales:
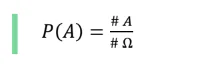
Para poder sacar los Cardinales de los experimentos surgen técnicas de conteo:
Técnicas de Conteo
Regla del Producto
La Regla del Producto se usa con procesos de varios pasos encadenados:
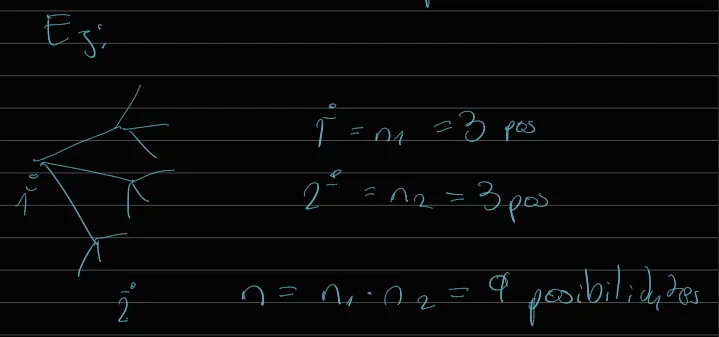
Regla de la Suma
La Regla de la Suma la utilizamos cuando tenemos resultados no encadenados e incompatibles.
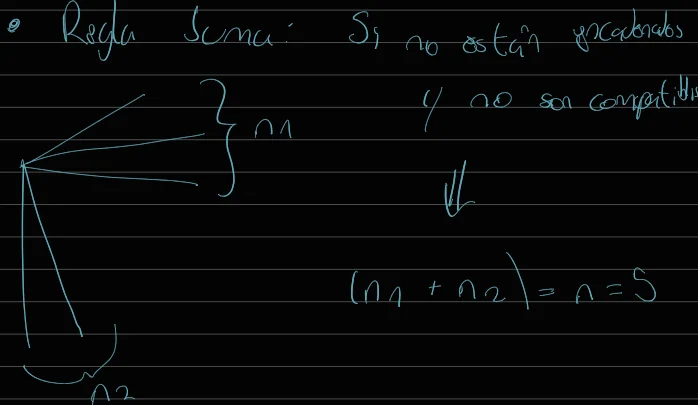
Arreglos
Los Arreglos son la herramienta de conteo que utilizaremos para contar extracciones sin reposición, y dónde a,b es distinto de b,a.
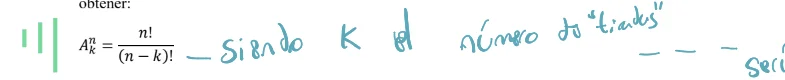
Combinaciones
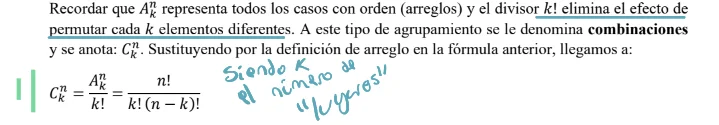
Las Combinaciones son como los Arreglos, pero sin que a,b sea distinto a b,a.
Para hacer eso, simplemente hay que diviidor el Arreglos entre k Factorial.
Conteo con repetidos:
Se da cuando si importa el orden, pero cambiar iguales no afecta:
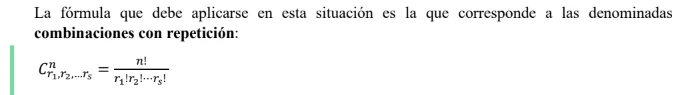
siendo r la cantidad de repetidos.
Espacios de Medida
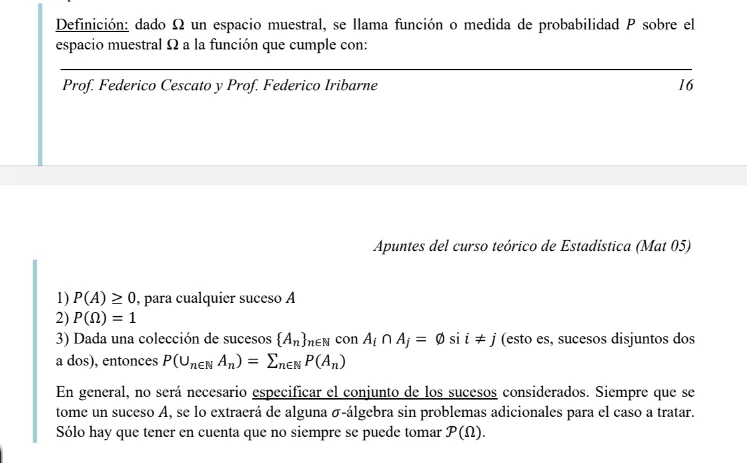
Si tenemos un Espacio Muestral Infinito, es dificil trabajar con probabilidad.
Pero se analizó que en ciertos espacios con Sigma Álgebra, que cumplen ciertas propiedades, nos lo facilitan.
En ellos la Probabilidad es una medida como el Contenido de Jordan creo.
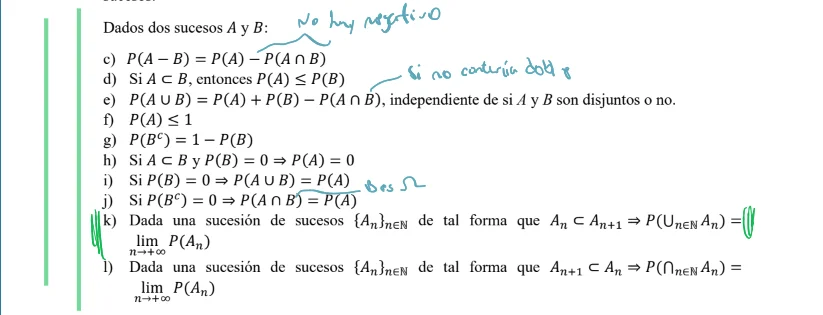
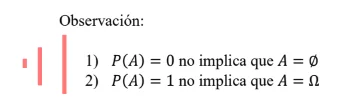
Por lo que veremos en Variables aleatorias continuas, y las Integrales.
Probabilidad Condicional
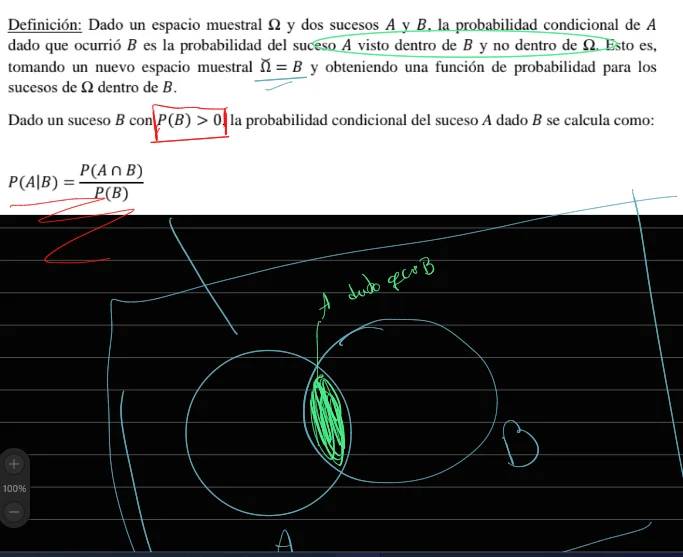
La Probabilidad Condicional es analizar la Probabilidad, pero tomando como Espacio Muestral un suceso que ya se que pasó.
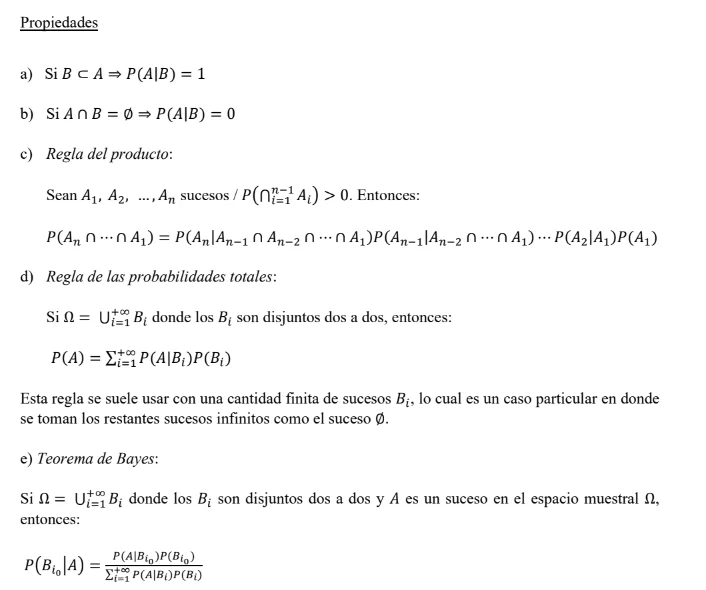
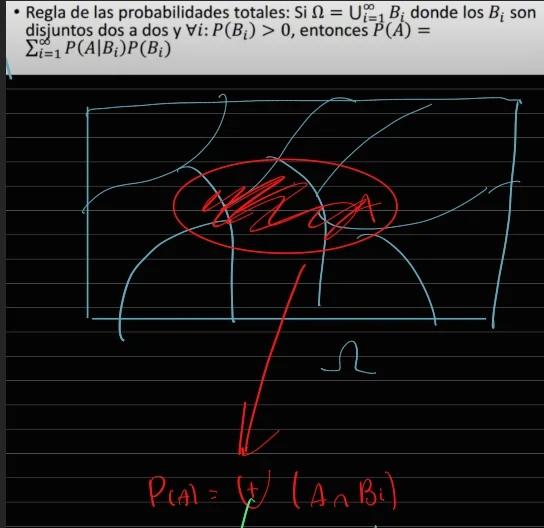
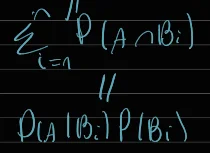
El Teorema de Bayes es como la probabilidad al revés, dice por ejempo, Yo saqué verde, entonces quiero saber de cuál viene.
Además Genera la Probabilidad Bayesiana, que se basa crear una Información a priori, y luego a base de observaciones y Experimentos actualizarla y volver a observar.
Independencia de Sucesos
Dos Sucesos son Sucesos Independientes cuando la ocurrencia de uno, no afecta la probabilidad de que ocurra el otro.

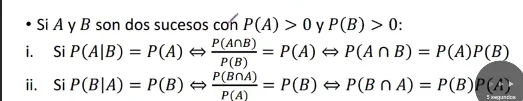
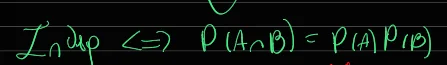
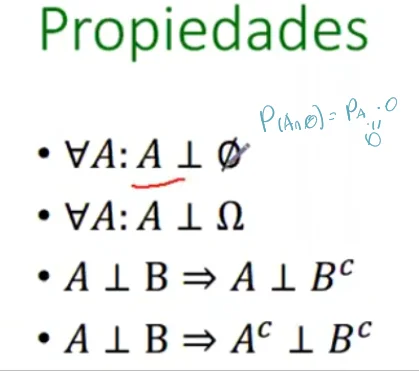
Si n Sucesos son Sucesos Independientes, entonces también lo son 2 a 2, pero el recíproco no es cierto.
Variables Aleatorias
Hay veces que en vez de interesarnos cada resultado posible, nos interesan resultados numéricos generados por el Experimento.
Estas cantidades reciben el nombre de Variables aleatorias. Por ejemplo si a cara,cara,cara le asigno 3.
Pasamos de un Espacio Muestral a los Reales.
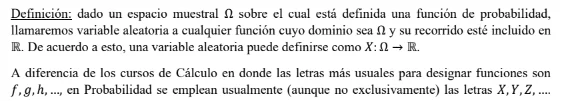
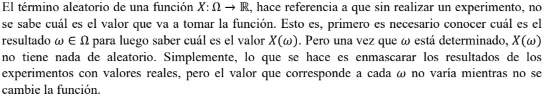
Las Variables son Aleatorias porque no es posible determinarlas sin hacer el experimento. Pero una vez hecho es invariable.
Función de Distribución
Llamamos Función de Distribución, a la Función que acumula las probabilidades hasta el punto x que le damos.
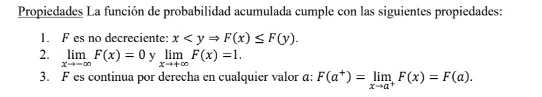
(Toda Función que cumpla eso es Función de Distribución, aunque no esté asociada a Probabilidad).
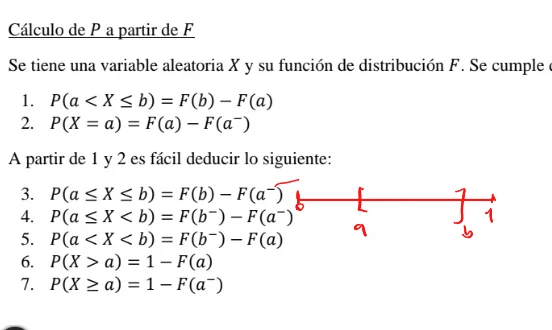
Podemos clasificar las Función de Distribución en cuatro grandes tipos:
- Discreta
- Mixta
- Absolutamente Continua
- Continua
Pero las más importantes son las primeras 3.
Si es escalonada con cantidad numerable de saltos, entonces es Discreta.
Si es Función continua en todo los Reales, y derivable salvo en una cantidad finita de puntos, es Absolutamente Continua.
La Mixta es la mezcla de las 2, discontinua en un número finito de puntos.
La Continua es como la Absolutamente Continua pero no derivable en un número no numerable de valores.
La Discreta y la Absolutamente Continua tienen Función de Densidad, que ya se verá más adelante.
Función de densidad
En las Discretas la Función de Densidad es la Función que le asigna a cada punto su valor de Probabilidad individual.
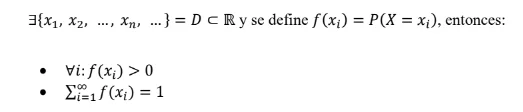
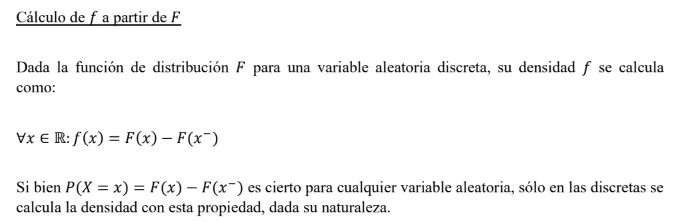
Si queremos sacarla desde una Función de Distribución Discreta, es el salto que hay entre cada escalón.
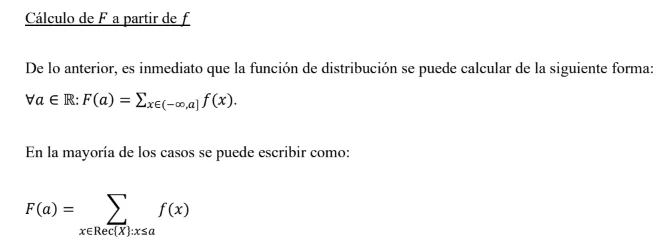
Por lo tanto, si queremos construir la de distribución a partir de la de densidad, hay que sumar todos los puntos hasta donde queramos:
En Absolutamente Continua:
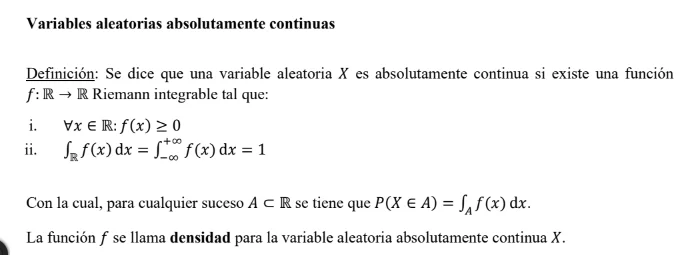
La Función de Densidad es la Derivada de la de Distribución.
En la Función de Densidad de una Absolutamente Continua podemos cambiar un punto individual como queramos, ya que al integrarlo no va a afectar para nada, pero se busca que sea continua por comunidad.
Por ello también cualquier suceso de un solo elemento tiene probabilidad nula.
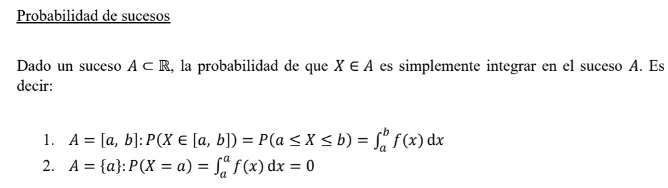
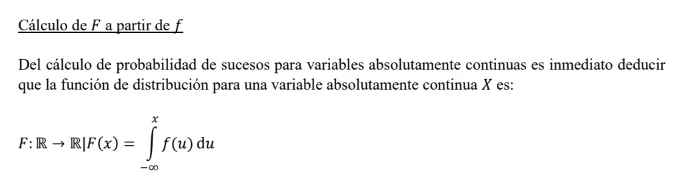
Las Mixtas no tienen estrictamente una Función de Densidad, pero se puede hacer una especie de mezcla para visualizarla.
Vectores Aleatorios
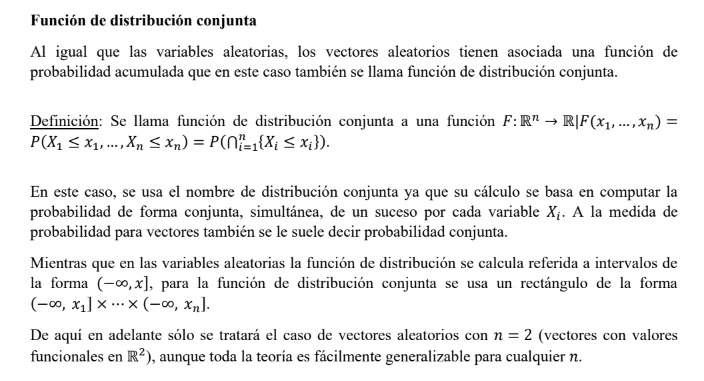
Los Vectores Aleatorios los utilizamos cuando queremos analizar más de un aspecto cuantitativo simultáneamente.
Esto es un experimento en el cual se obtienen varias Variables aleatorias simultáneamente.
Por lo que naturalmente surge la idea de ordenarlas en Vectores.
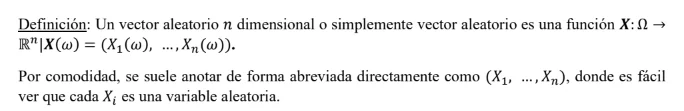
Ahora las Función de Distribución acumulan en Intervalos rectangulares construidos usando el Producto Cartesiano.
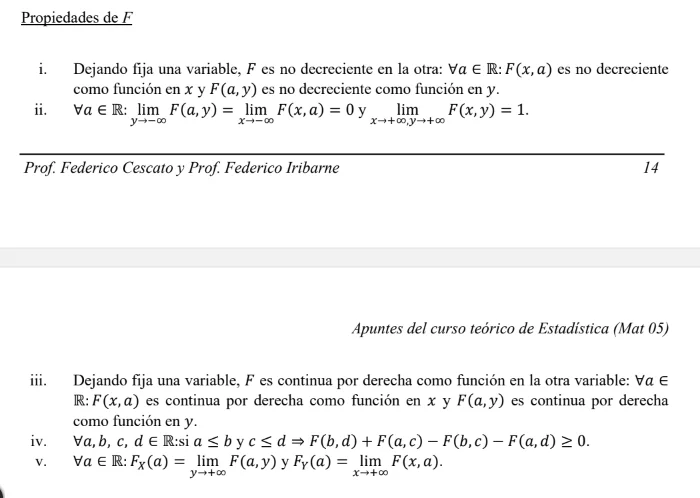
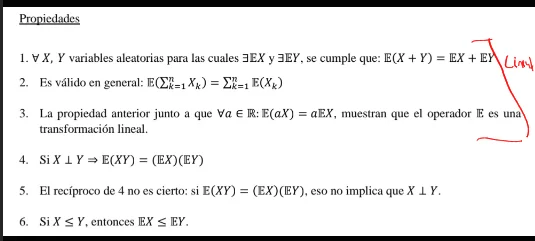
La propiedad 5 es interesante, ya que nos va a permitir calcular la Función de Distribución de cada variable por separado, lo que llamaremos Marginal.
También clasificaremos estas funciones en Absolutamente Continua, Discretas etc..
Discretos:

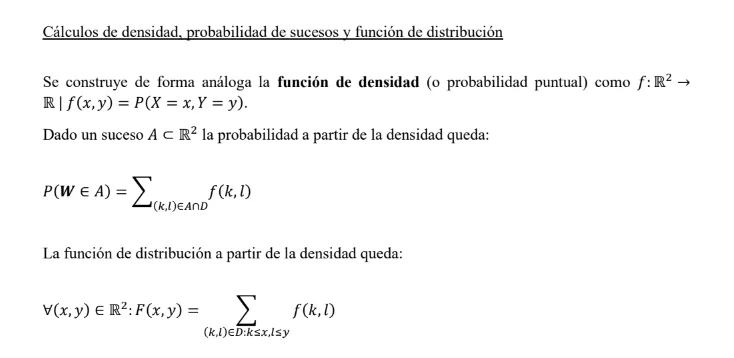
En los Discreta también se pueden obtener las Función de Densidad Marginales.
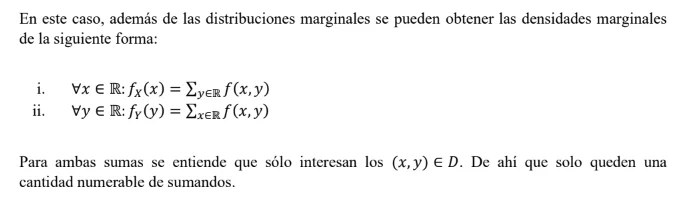
Absolutamente Continuas
También es una generalización de las Variables aleatorias Absolutamente Continuas:
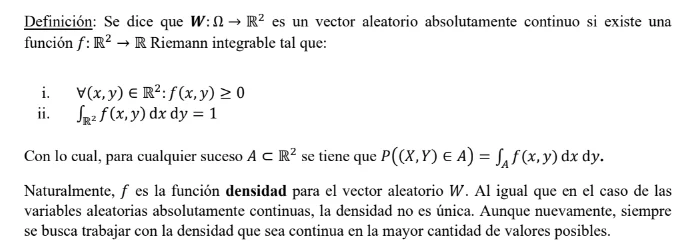
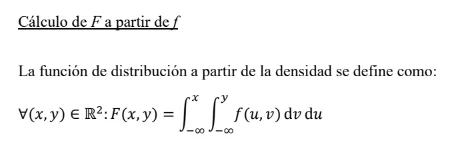
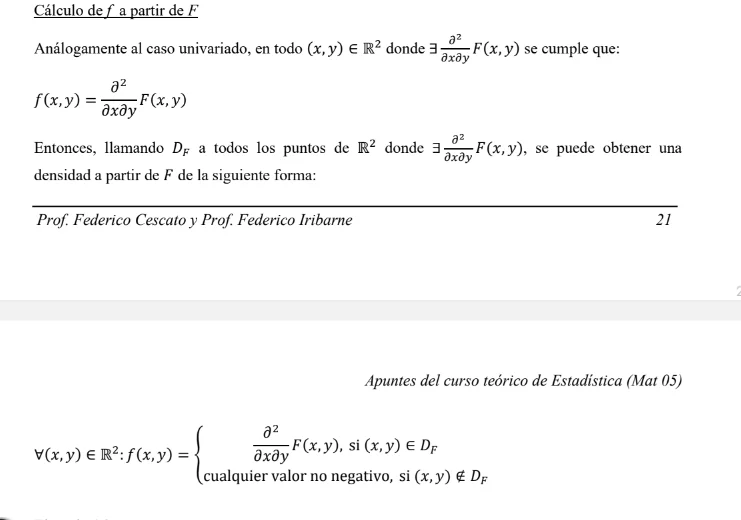
Si quiero la Marginal de x, fijo un x y derivo en y:
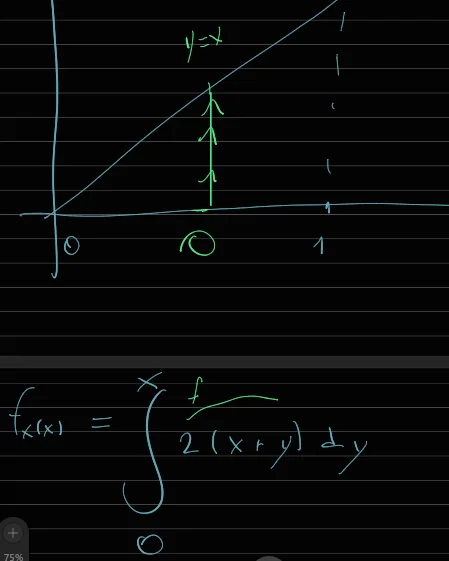
Debo dividir en las zonas que corresponda.
Independencia de Variables Aleatorias:
Es la generalización de la idea de Sucesos Independientes. 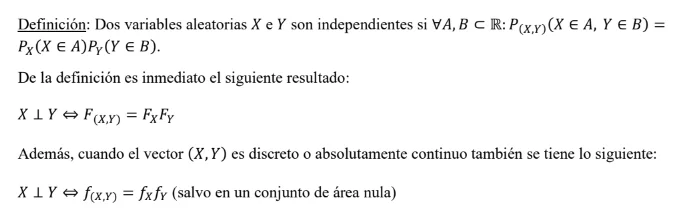
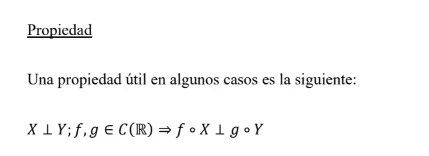
En las continuas no puedo elegir un punto en particular, así que elijo una región no nula.
Parámetros Poblacionales y muestrales
Los Parámetros Poblacionales son cantidades que describen Experimentos o Poblaciónes individuales, y nos permiten compararlas.
Los Parámetros Poblacionales más utilizados son los de Posición y Dispersión.
Los Parámetros Muestrales son la aproximación hecha con datos obtenidos de una muestra, a los Parámetros Poblacionales.
Poblacionales
Moda
La Moda se interpreta como el o los puntos con mayor Probabilidad.
Si es Discreta es el punto con más valor en la Función de Densidad
Si es Absolutamente Continua, son todos los puntos donde tenga un Máximo relativo.
Si es Mixta, la Moda la aporta la parte discreta.
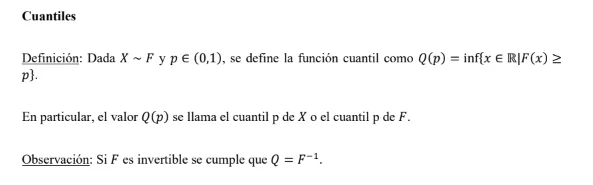
Cuantiles
Los Cuantiles calculan el mínimo punto en el que se llega a cierta Probabilidad:
Mediana
Esperanza
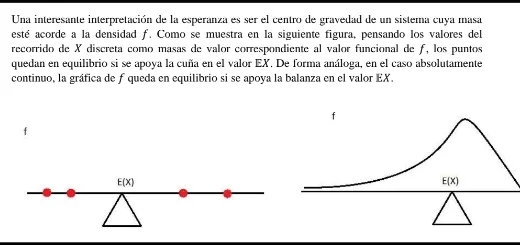
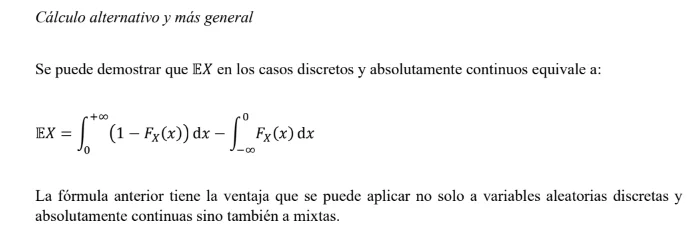
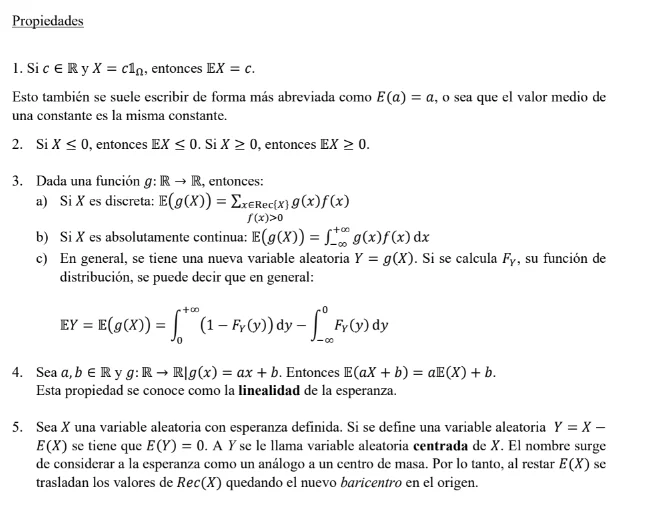
La Esperanza es el valor que se espera tome el Promedio al tomar datos de una muestra.
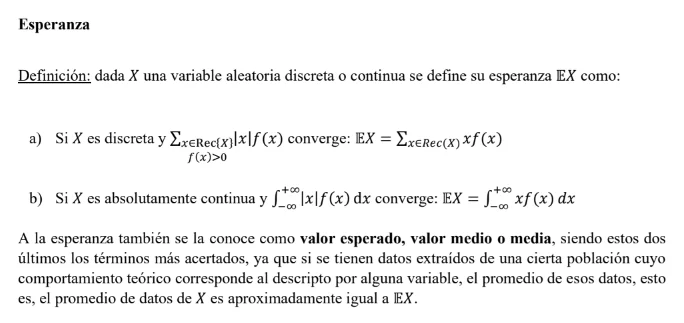
Es como una especie de centro de masa:
Momentos de orden k
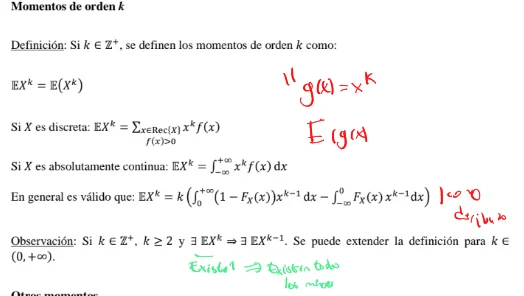
Los Momento de Orden k son como definir una nueva función x a la k, y calcularle la esperanza:
El que más uso tiene es el de orden 2
Esperanza con Vectores Aleatorios
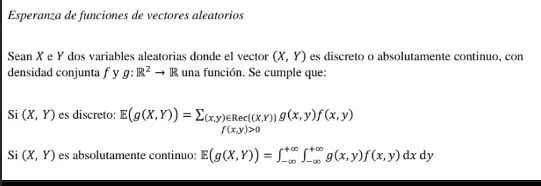
Cuando estamos con Vectores Aleatorios la Esperanza se calcula usando una función g, que generalmente va a ser x*y
Esperanza de las marginales
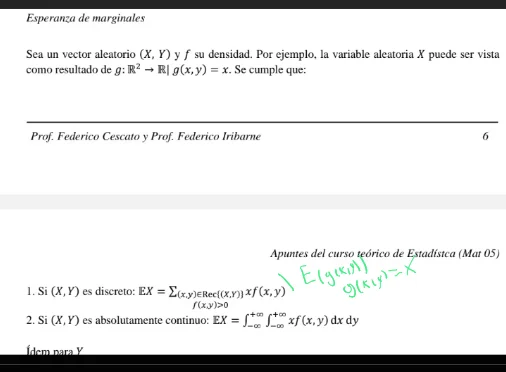
En este caso usamos solo la variable en la que queremos la marginal como g.
Varianza
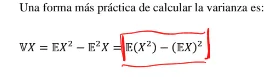
La Varianza es el Momento de Orden k de orden 2, pero además centrado.
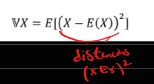
Sin embargo una forma más fácil de calculara es:
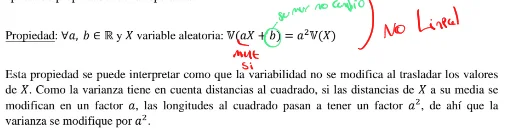
La Varianza NO ES LINEAL, aunque como son distancias, no se modifica por la suma:
Desviación Estándar
La Desviación Estándar es la Raíz Cuadrada de la Varianza.
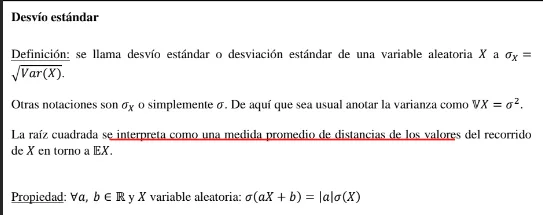
Se interpreta como un Promedio de las distancias de los valores del recorrido con la Esperanza.
Teorema de Chebichev
El Teorema de Chebichev nos permite acotar la Probabilidad de que una variable aleatoria se desvíe de su Esperanza más que un cierto épsilon:
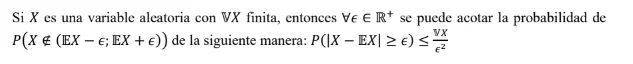
Sin embargo, suele dar una cota elevada de más.
Ley débil de los grandes números
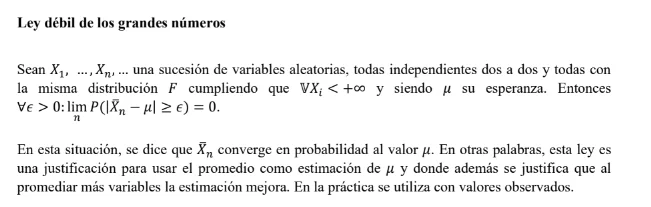
La Ley débil de los grandes números nos dice que cuantas más observaciones tengamos del mismo experimento al momento de promediarlas, más precisa va a ser nuestra estimación con el que sería el promedio 100% preciso.
Covarianza
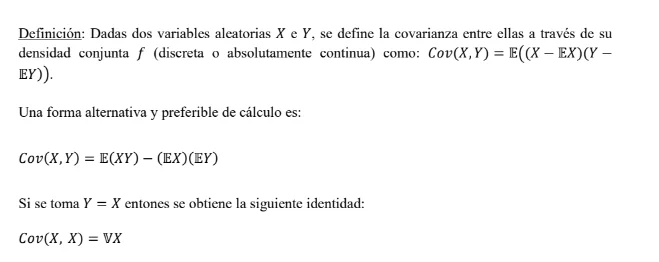
La Covarianza analiza como varían en conjunto:
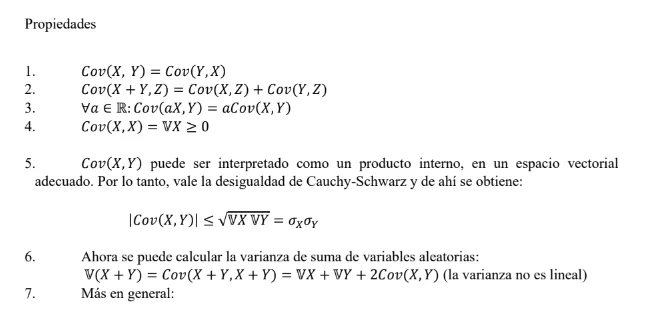
La Covarianza puede ser interpretada como un Producto Interno.
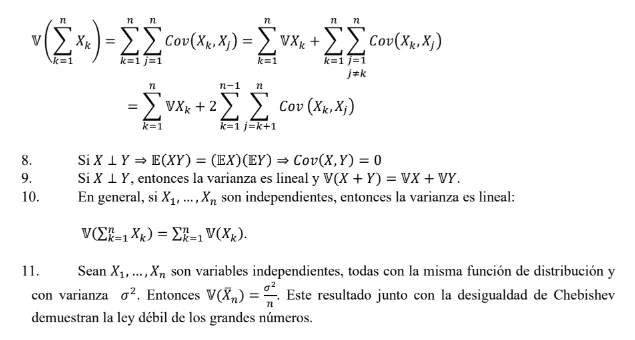
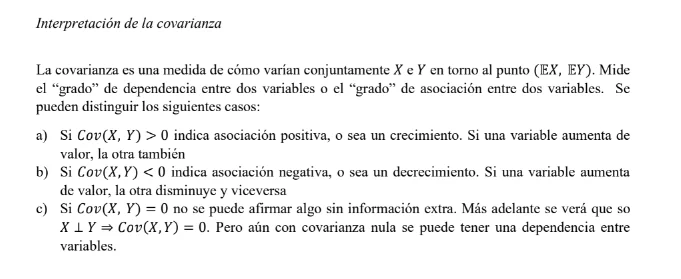
Lo malo de la Covarianza es que no tiene en cuenta las escalas, y es relativa a la varianza de cada variable.
Por eso surge:
Coeficiente de correlación lineal
El Coeficiente de correlación Lineal se obtiene al relativizar la Covarianza a la escala de cada variable:
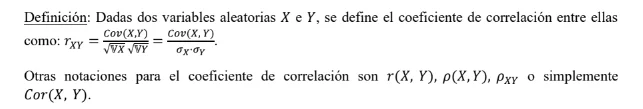
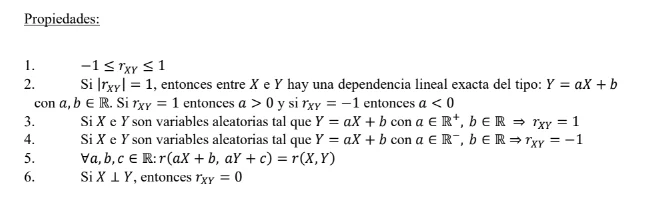
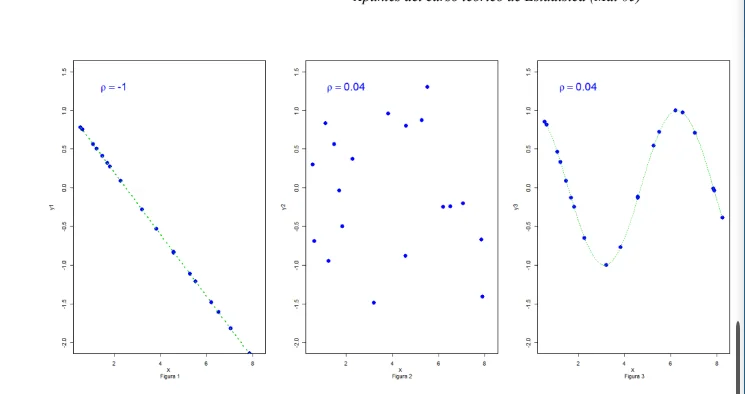
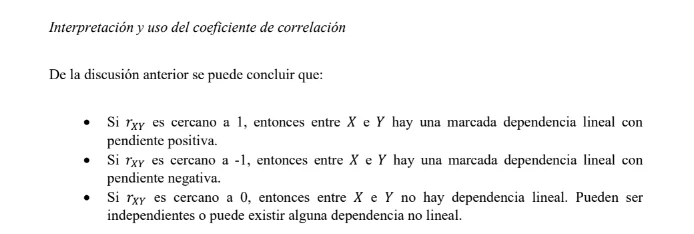
En este si es 1 o -1 es exactamente una recta, si es 0 pueden ser Sucesos Independientes o tener una Dependencia que no es lineal:
Parámetros muestrales:
Una Muestra está formada por n valores, obtenidos se la misma Población, son valores numéricos que provienen del mundo no de variables aleatorias.
Función de Distribución Empírica
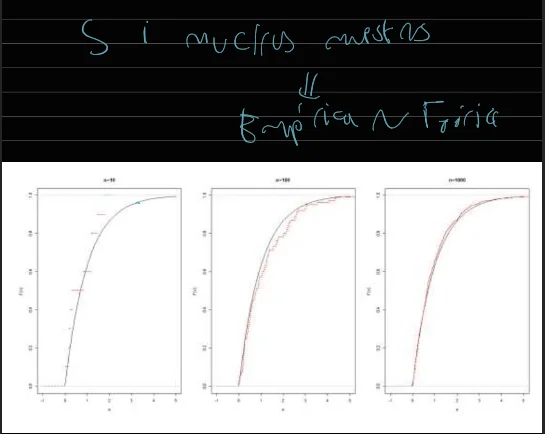
La Función de Distribución Empírica es la aproximación a la Función de Densidad :
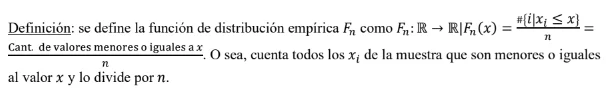
Para calcularla es bueno ordenar los valores en forma creciente antes.
Moda Muestral
La Moda Muestral son los valores que más re repiten en la muestra.
Cuantil muestral
El Cuantil muestral es exactamente igual al Cuantil pero este es en la Función de Distribución Empírica
Mediana Muestral
Hay varias formas de definir la Mediana Muestral, pero vamos usar la del Cuantil muestral 0.5.
Media Muestral
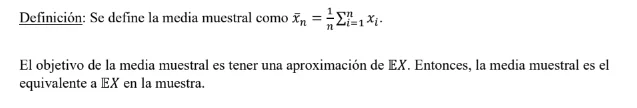
La Media muestral es el Promedio, y es la Aproximación a la Esperanza.
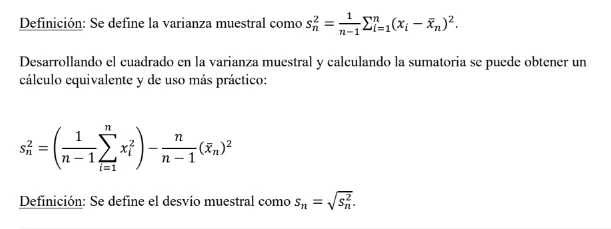
Varianza muestral
La Varianza Muestral y por lo tanto el Desvío Muestral, se calculan dividiendo con n-1
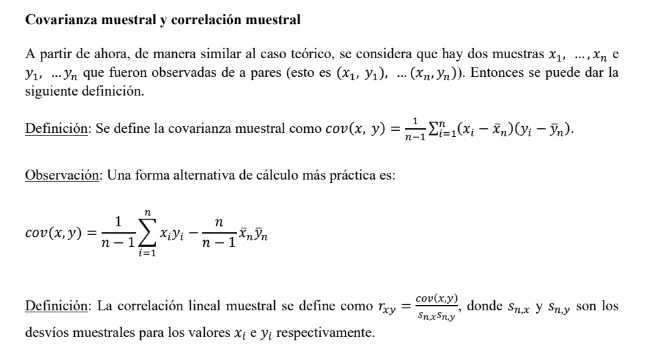
Covarianza muestral
Para la Covarianza Muestral se hace lo mismo que con la Varianza Muestral de dividir entre n-1.
Distribuciones especiales
Las distribuciones especiales son como Función de Distribución genéricas, que se adaptan a cierto tipo de Experimento , y permiten trabajar con Probabilidad de forma más rápida y sin tener que analizar cada resultado puntual.
Cada una tiene ciertos parámetros para ajustarse al experimento concreto.
Las más comunes son las Discreta y Absolutamente Continua.
Discretas:
Bernoulli
La Distribución de Bernoulli es un poco la base de las demás, y se usa para modelar Experimentos donde los resultados posibles son solo éxito o fracaso.
Se usa el 1 para representar el éxito y el 0 para el fracaso:
El parámetro a regular es p, que es la probabilidad de que ocurra el éxito.
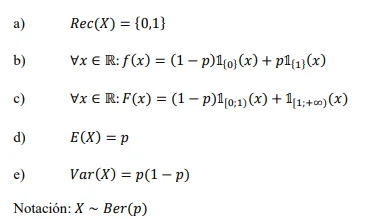
Binomial
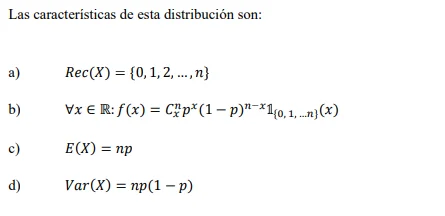
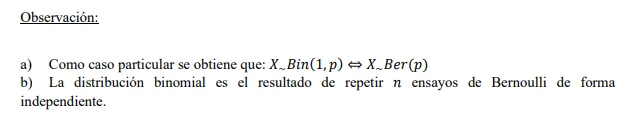
La Distribución Binomial se obtiene al repetir n ensayos con Distribución de Bernoulli, y la misma Probabilidad p.
Y la X es la cantidad de éxitos entre las observaciones.
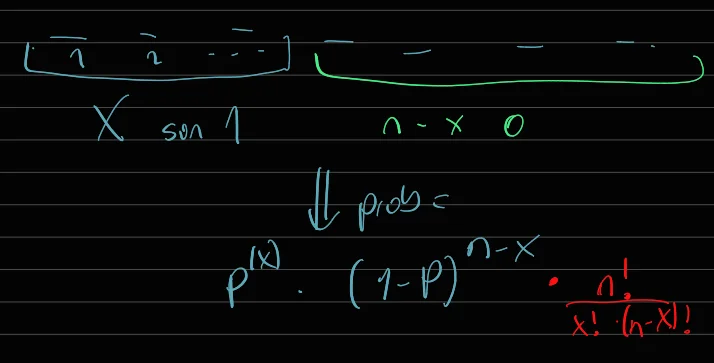
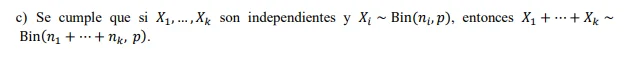
Si quiero hacer una suma de Distribución Binomiales solo tengo que hacer una con la suma de las n (Solo si son Independientes):
Hipergeométrica
La Distribución Hipergeométrica se utiliza para modelar un muestreo Sin Reposición:
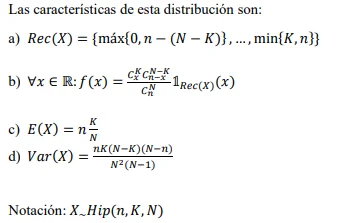
El recorrido se debe ajustar según el Experimento, ya que a veces, si saco más muestras de los fracasos que tengo, no puedo empezar con 0 éxitos.
X nuevamente es cantidad de éxitos observados al sacar n.
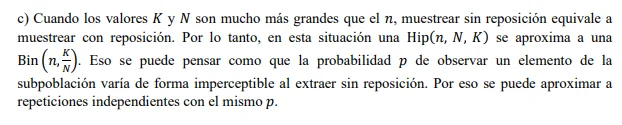
Si K y N son mucho mayores a la n, podemos aproximarla a una Distribución Binomial:
Poisson
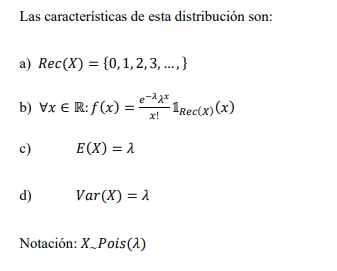
La Distribución de Poisson es útil para el conteo en unidades de tiempo o área, vol, etc, de un evento raro.
Su parámetro es la Intensidad del fenómeno, y representa el Promedio de observaciones por unidad de observación.
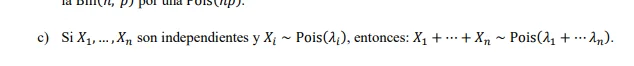
Geométrica
La Distribución Geométrica modela ensayos con Distribución de Bernoulli hasta que ocurre el primer éxito, por lo que x es el lugar donde ocurrió el 1ero.
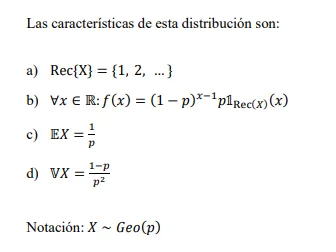
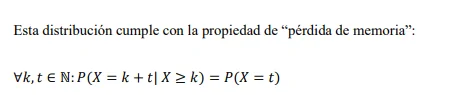
Tiene "Perdida de memoria" lo que quiere decir que tirar de 0, o tirar desde cualquier punto tiene la misma probabilidad.
Binomial Negativa
La Distribución Binomial Negativa es como una expansión de la Distribución Geométrica, ya que modela realización de ensayos con Distribución de Bernoulli hasta r éxitos.